前言
熟悉了 AFL 的使用之后,接下来应该分析一下 AFL 的源代码来理解 AFL 的 Fuzz 原理。关于 AFL 的源码分析已经有很多前辈珠玉在前了,所以也想过到底要不要写这篇文章。想了想还是打算动笔,也算是对自己学到的东西做总结。
AFL源码架构
AFL 源码架构大体可以分为三个模块:
AFL 源码架构
├── 核心模块 (afl-fuzz.c)
├── 插桩模块
│   ├── 汇编 (afl-gcc.c, afl-as.c)
|	├── llvm  (llvm_mode)
│   └── qemu  (qemu-mode)
└── 辅助模块
     ├── 输入优化 (afl-tmin, afl-cmin)
     ├── 状态分析 (afl-showmap.c, afl-analyze.c)
	 ├── 内存检测 (libdislocator)
 	 ├── 捕获输入 (libtokencap)
 	 └── 资源管理 (afl-whatsup.sh, afl-gotcpu.c)
下面主要对核心模块和插桩模块进行分析来了解 AFL 的工作原理。
插桩模块分析
插桩 (instrumentation) 的核心概念是:在保证原程序逻辑完整性的情况下,在程序中插入一些代码来收集运行时的执行状态。
在 AFL 中一共有三种插桩模块,分别是通过afl-gcc.c和afl-as.c的汇编插桩,以及通过 LLVM Pass 的 LLVM 模式插桩,最后是通过 QEMU 对二进制文件的插桩。
插入的代码从用途上主要分为两类:
- 记录目标程序执行过程中的路径覆盖信息,需保证在每个基本块上都有插入;
- 初始化共享内存以及 forkserver。
插桩的代码通常只需要几行汇编代码,并不会做太复杂的操作,否则会对性能产生影响。在 AFL 中插桩被用来搜集代码覆盖率,也就是目标程序执行了哪些路径。
汇编插桩
首先通过对afl-gcc.c对 gcc 做一层简单的封装,然后交给封装后的 as 汇编器来处理。这里将会查找汇编文件中的.text节区,并在各控制流指令或基本块入口等位置插入跳板代码,以实现插桩操作。
afl-gcc.c是对 gcc 编译器的封装,其作用是修改用户的编译命令,使其自动包含 AFL 所需的插桩逻辑,进而支持模糊测试。它的目标是修改传递给编译器的参数,确保编译器能够正确地为 AFL 插桩编译代码,从而使 AFL 能够进行有效的模糊测试。
其主要工程流程如下:
- 通过
find_as函数查找到as汇编器的位置 - 然后调用
edit_params函数解析用户传入的数组,并生成新的参数数组。 - 根据参数数组调用真正的编译器(如gcc、clang),让其生成汇编文件。
- 最终由
afl-as替代原始as汇编器,对汇编文件进行插桩。
由于插桩在汇编阶段完成,因此afl-gcc不直接插桩,而是通过参数重写将插桩交给afl-as汇编器。
afl-as工作流程如下:
- 调用
edit_params()函数调整传入的参数。 - 执行
add_instrumentation()函数对.text节中的代码进行插桩。 - 使用
fork函数创建子进程。 - 子进程调用真实的
as对插桩后的汇编代码进行编译。
插桩仅针对.text节,跳过.data、.bss等非代码段。插桩点主要包括函数标签、控制流跳转(如jmp、call等汇编指令)和编译器生成的中间标签(如LBB)。
同时该封装器还支持设置AFL_HARDEN环境变量启用堆栈保护、设置AFL_USE_ASAN来启用 ASAN,以发现内存错误。
在 AFL 汇编插桩模式中,核心逻辑主要在afl-gs.c文件的add_instrumentation()函数中。它负责对编译器生成的汇编文件进行处理,在合适的位置插入 AFL 所需的汇编代码,核心逻辑就是识别哪些位置是合适的插桩点并插桩。
static void add_instrumentation(void) {

  ......

  while (fgets(line, MAX_LINE, inf)) {

	//判断算法符合插桩条件
    if (!pass_thru && !skip_intel && !skip_app && !skip_csect && instr_ok &&
        instrument_next && line[0] == '\t' && isalpha(line[1])) {

	  //插入跳板汇编代码
      fprintf(outf, use_64bit ? trampoline_fmt_64 : trampoline_fmt_32,
              R(MAP_SIZE));

      instrument_next = 0;
      ins_lines++;

    }

  ......
只有满足以下条件的语句才会被插桩:
- 不处于 pass-throug 模式(无需插桩);
- 当前语法不是 Intel 风格;
- 不在 inline assembly(#APP)块中;
- 当前节区是
.text; - 已经识别到是 label 或跳转指令后的 basic block;
- 是以
\t开头且第二个字符是字母的合法汇编指令。
插桩的内容包含变量main_payload_64和trampoline_fmt_64,这两个变量定义在afl-as.h中。不过,main_payload_64主要是定义与 AFL 相关的函数,因此我们先来看trampoline_fmt_64 的代码:
static const u8* trampoline_fmt_64 =
    "leaq -(128+24)(%%rsp), %%rsp\n"         // (1) 创建栈帧
    "movq %%rdx,  0(%%rsp)\n"                // (2) 保存寄存器
    "movq %%rcx,  8(%%rsp)\n"
    "movq %%rax, 16(%%rsp)\n"
    "movq $0x%08x, %%rcx\n"                  // (3) 加载随机 BB ID
    "call __afl_maybe_log\n"                 // (4) 调用日志记录函数
    "movq 16(%%rsp), %%rax\n"                // (5) 恢复寄存器
    "movq  8(%%rsp), %%rcx\n"
    "movq  0(%%rsp), %%rdx\n"
    "leaq (128+24)(%%rsp), %%rsp\n";         // (6) 恢复栈指针
插桩逻辑的作用:保存当前进程的状态(寄存器等),随机生成一个当前基本块的 ID,通过RCX传递它。调用__afl_maybe_log收集覆盖信息。
main_payload_64变量主要定义了__afl_maybe_log()函数,用于初始化模糊测试环境并收集目标代码覆盖率。我们将插桩的汇编代码替换为易理解的 C 代码来分析。
#define READ_PIPE_FD 198
#define WRITE_PIPE_FD 199

char _afl_maybe_log(__int64 r1, __int64 r2, __int64 r3, __int64 bbid)
{
    // 第一次调用:初始化
    if (!_afl_area_ptr) {
        // (1) 通过环境变量获取共享内存
        shmid_str = getenv("__AFL_SHM_ID");
        shmid_int = atoi(shmid_str);
        shm = shmat(shmid_int, NULL, 0);
        _afl_area_ptr = shm;

        // (2) 与 fuzzer 通信建立 fork server
        if (write(WRITE_PIPE_FD, &tmp, 4) == 4) {
            while (1) {
                if (read(READ_PIPE_FD, &tmp, 4) != 4)
                    break;
                pid = fork();
                if (!pid) goto resume;
                write(WRITE_PIPE_FD, &pid, 4);
                waitpid(pid, &tmp, 0);
                write(WRITE_PIPE_FD, &tmp, 4);
            }
            _exit(0);
        }
    }

resume:
    // (3) 记录覆盖路径信息
    edge = _afl_prev_loc ^ bbid;
    _afl_prev_loc = (_afl_prev_loc ^ edge) >> 1;
    _afl_area_ptr[edge]++;
}
这段代码主要做了两件事情:初始化共享内存和 forkserver,以及记录路径覆盖信息。
forkserver 是 AFL 性能优化的关键。传统的模糊测试每次测试都调用execve启动目标程序,开销巨大。而 AFL 通过引入 forkserver 机制,将这部分开销显著降低。
- 初次执行时,由父进程创建一个 forkserver 循环;
- 每次 AFL 发起测试时,父进程只需
fork()出一个子进程执行测试代码; - 测试完成后,父进程回收子进程并将状态返回给 AFL。
这样就避免了频繁加载程序带来的资源消耗,大幅提升执行效率。由于 AFL 需要与 forkserver 传递一些信息(指令和状态码等)所以需要与 forkserver 建立通信,在源码中 AFL 是通过管道机制来与 forkserver通信的
AFL 与 forkserver 通信流程:
- AFL 在启动程序前,会预先创建一对匿名管道,用于与目标程序的 forkserver 通信。
- 目标程序在首次调用
__afl_maybe_log时触发初始化,通过__afl_maybe_log判断是否为首次进入。 - 初始化流程:
- 通过环境变量
__AFL_SHM_ID获取共享内存ID,调用shmat映射共享内存,用于保存覆盖率信息; - 通过管道与 AFL 进行握手,确保通信建立;
- 启动 forkserver 循环:
- 父进程阻塞等待 AFL 发出命令;
- 接收命令后
fork()一个子进程; - 子进程执行测试代码;
- 父进程等待子进程结束,收集状态并将结果回传给 AFL。
- 通过环境变量
AFL 记录 coverage(覆盖)是以 edge (边)为单位的,edge 是由两个 basic block (基本块)组成。为什么不以基本块来来计算 coverage 呢?以下以一个例子来说明。
例如有 basic block A 和 B,A->B 和 B->A 都会标记 B 被覆盖,但是这样无法记录路径上下文信息,因此 coverage 相同;
但是在 edge 覆盖中,记录从哪个 basic block 跳转到哪个 basic block。这样 A->B 和 B-> 是两个不同的 edge。这样就可以记录控制流的顺序,保留上下文信息,覆盖的粒度更细。
插桩代码会为每个 basic block 生成一个随机 ID(bbid)然后通过异或运算来计算 edge:
原始 AFL 通过地址移位和 XOR 生成 block ID,再用 E = B ^ (B' >> 1) 生成 edge ID:
edge = prev_loc ^ bbid;            //edge = 上一个块和当前块的ID的异或
_afl_area_ptr[edge]++;             //更新对应的 edge 的执行次数
prev_loc = (prev_loc >> 1) ^ bbid; //更新 prev_loc,为下一次 edge 做准备
得到 edge 值后,将其记录到共享内存中。父进程等待子进程执行完毕,然后将子进程的退出状态传递给 AFL。AFL 根据共享内存中的覆盖率信息判断该输入是否具有 “价值”(是否发现了新的路径或崩溃),并决定是否保留该输入。
llvm_mode
LLVM 模式通过 LLVM Pass 来对目标程序进行编译插桩,它要比通过直接通过汇编进行插桩覆盖粒度更精细。而且性能的开销要低很多,灵活性也更高。
llvm_mode目录下分为三个文件:afl-clang-fast.c、 afl-llvm-pass.so.c、afl-llvm-rt.o.c。
afl-clang-fast.c会编译出 afl-clang-fast 可执行文件,类似于 afl-gcc.c 一样对目标编译器进行一个封装,从而使用 LLVM Pass 来进行插桩。
Pass 插桩代码:
//遍历所有函数中的所有基本块,在满足条件的基本块前插入一段记录代码
bool AFLCoverage::runOnModule(Module &M) {

  //获取当前模块的上下文
  LLVMContext &C = M.getContext();

  IntegerType *Int8Ty  = IntegerType::getInt8Ty(C);
  IntegerType *Int32Ty = IntegerType::getInt32Ty(C);
  char be_quiet = 0;

  if (isatty(2) && !getenv("AFL_QUIET")) {
    SAYF(cCYA "afl-llvm-pass " cBRI VERSION cRST " by <lszekeres@google.com>\n");
  } else be_quiet = 1;

  //从环境变量中获取插桩比例,若未设置则默认百分比
  char* inst_ratio_str = getenv("AFL_INST_RATIO");
  unsigned int inst_ratio = 100;

  if (inst_ratio_str) {
    if (sscanf(inst_ratio_str, "%u", &inst_ratio) != 1 || !inst_ratio || inst_ratio > 100)
      FATAL("Bad value of AFL_INST_RATIO (must be between 1 and 100)");
  }

  //__afl_area_ptr:指向 AFL 在运行时创建的共享内容区域,用于记录覆盖信息。
  GlobalVariable *AFLMapPtr = new GlobalVariable(M, PointerType::get(Int8Ty, 0), false, GlobalValue::ExternalLinkage, 0, "__afl_area_ptr");

  //__afl_prev_loc:TLS 变量,记录上一个基本块的位置(用于构造边:cur_loc ^ prev_loc)
  GlobalVariable *AFLPrevLoc = new GlobalVariable(
      M, Int32Ty, false, GlobalValue::ExternalLinkage, 0, "__afl_prev_loc",
      0, GlobalVariable::GeneralDynamicTLSModel, 0, false);

  int inst_blocks = 0;

  //遍历模块中的函数和基本块
  for (auto &F : M)
    for (auto &BB : F) {

      //获取当前基本块的第一个可插入位置
      BasicBlock::iterator IP = BB.getFirstInsertionPt();
      IRBuilder<> IRB(&(*IP));

      //如果超出了插桩比例,跳过当前基本块
      if (AFL_R(100) >= inst_ratio) continue;

	  //随机生成一个0~MAP_SIZE范围的数作为当前基本块ID
      unsigned int cur_loc = AFL_R(MAP_SIZE);
      ConstantInt *CurLoc = ConstantInt::get(Int32Ty, cur_loc);

	  //以下部分代码被插入到目标程序

      //读取 __afl_prev_loc
      LoadInst *PrevLoc = IRB.CreateLoad(AFLPrevLoc);
      PrevLoc->setMetadata(M.getMDKindID("nosanitize"), MDNode::get(C, None));
      Value *PrevLocCasted = IRB.CreateZExt(PrevLoc, IRB.getInt32Ty());

	  //计算覆盖索引:index = cur_loc ^ prev_loc(从哪个基本块跳到哪个基本块)
      LoadInst *MapPtr = IRB.CreateLoad(AFLMapPtr);
      MapPtr->setMetadata(M.getMDKindID("nosanitize"), MDNode::get(C, None));
      Value *MapPtrIdx = IRB.CreateGEP(MapPtr, IRB.CreateXor(PrevLocCasted, CurLoc));

	  //对共享内存的当前路径计数器加 1
      LoadInst *Counter = IRB.CreateLoad(MapPtrIdx);
      Counter->setMetadata(M.getMDKindID("nosanitize"), MDNode::get(C, None));
      Value *Incr = IRB.CreateAdd(Counter, ConstantInt::get(Int8Ty, 1));
      IRB.CreateStore(Incr, MapPtrIdx)->setMetadata(M.getMDKindID("nosanitize"), MDNode::get(C, None));

	  //更新 __afl_prev_loc
      StoreInst *Store = IRB.CreateStore(ConstantInt::get(Int32Ty, cur_loc >> 1), AFLPrevLoc);
      Store->setMetadata(M.getMDKindID("nosanitize"), MDNode::get(C, None));
      inst_blocks++;
}
afl-llvm-rt.o.c实现了插桩时插入到目标程序的代码。
//共享内存映射
static void __afl_map_shm(void) {
  u8 *id_str = getenv(SHM_ENV_VAR);
  if (id_str) {
    u32 shm_id = atoi(id_str);
    __afl_area_ptr = shmat(shm_id, NULL, 0);
    if (__afl_area_ptr == (void *)-1) _exit(1);
    __afl_area_ptr[0] = 1;
  }
}

//forkserver 启动
static void __afl_start_forkserver(void) {

  static u8 tmp[4];
  s32 child_pid;
  u8  child_stopped = 0;
  if (write(FORKSRV_FD + 1, tmp, 4) != 4) return;

  while (1) {
    u32 was_killed;
    int status;
    if (read(FORKSRV_FD, &was_killed, 4) != 4) _exit(1);
    if (child_stopped && was_killed) {
      child_stopped = 0;
      if (waitpid(child_pid, &status, 0) < 0) _exit(1);
    }

    if (!child_stopped) {
      child_pid = fork();
      if (child_pid < 0) _exit(1);
      if (!child_pid) {
        close(FORKSRV_FD);
        close(FORKSRV_FD + 1);
        return;
      }
    } else {
      kill(child_pid, SIGCONT);
      child_stopped = 0;
    }
    if (write(FORKSRV_FD + 1, &child_pid, 4) != 4) _exit(1);

    if (waitpid(child_pid, &status, is_persistent ? WUNTRACED : 0) < 0)
      _exit(1);

    if (WIFSTOPPED(status)) child_stopped = 1;

    if (write(FORKSRV_FD + 1, &status, 4) != 4) _exit(1);
  }
}

//持久化循环
int __afl_persistent_loop(unsigned int max_cnt) {

  static u8  first_pass = 1;
  static u32 cycle_cnt;

  if (first_pass) {
    if (is_persistent) {

      memset(__afl_area_ptr, 0, MAP_SIZE);
      __afl_area_ptr[0] = 1;
      __afl_prev_loc = 0;
    }

    cycle_cnt  = max_cnt;
    first_pass = 0;
    return 1;
  }

  if (is_persistent) {
    if (--cycle_cnt) {

      raise(SIGSTOP);

      __afl_area_ptr[0] = 1;
      __afl_prev_loc = 0;

      return 1;
    } else {
      __afl_area_ptr = __afl_area_initial;
    }
  }
  return 0;
}

//初始化流程
void __afl_manual_init(void) {
  static u8 init_done;

  if (!init_done) {
    __afl_map_shm();
    __afl_start_forkserver();
    init_done = 1;
  }
}

__attribute__((constructor(CONST_PRIO))) void __afl_auto_init(void) {
  is_persistent = !!getenv(PERSIST_ENV_VAR);
  if (getenv(DEFER_ENV_VAR)) return;
  __afl_manual_init();
}

void __sanitizer_cov_trace_pc_guard(uint32_t* guard) {
  __afl_area_ptr[*guard]++;
}


void __sanitizer_cov_trace_pc_guard_init(uint32_t* start, uint32_t* stop) {
  u32 inst_ratio = 100;
  u8* x;

  if (start == stop || *start) return;

  x = getenv("AFL_INST_RATIO");
  if (x) inst_ratio = atoi(x);

  if (!inst_ratio || inst_ratio > 100) {
    fprintf(stderr, "[-] ERROR: Invalid AFL_INST_RATIO (must be 1-100).\n");
    abort();
  }

  *(start++) = R(MAP_SIZE - 1) + 1;

  while (start < stop) {
    if (R(100) < inst_ratio) *start = R(MAP_SIZE - 1) + 1;
    else *start = 0;
    start++;
  }
}
qemu_mode
AFL 的二进制模式(又称黑盒模式)是通过 QEMU 模拟器实现的。不过,QEMU 默认并不会记录覆盖率,因此 AFL 通过修改 QEMU 的源代码来实现这一功能。相关的 patch 后的 diff 文件可以在qemu_mode/patches/中找到,下面简要介绍一下这些修改的内容。
diff 文件描述了对 QEMU 源码修改了哪些内容:
syscall.diff:修改 kill 处理,确保发送SIGABRT时 forkserver 线程能够接收到从而不中断 fuzz。configure.diff / memfd.diff:使用内存映射(memory mapping)而不是内存文件描述符(memory fd)。elfload.diff:在解析执行文件的元数据时,初始化afl_start_code和afl_end_code,这两个标记代表需要被收集覆盖率的程序代码地址的起始和结束位置,afl_entry_point用来记录程序的入口点。
cpu-exec.diff:插入覆盖率记录宏AFL_QEMU_CPU_SNIPPET2,插入 TB 翻译宏AFL_QEMU_CPU_SNIPPET1。
--- qemu-2.10.0-rc3-clean/accel/tcg/cpu-exec.c  2017-08-15 11:39:41.000000000 -0700
+++ qemu-2.10.0-rc3/accel/tcg/cpu-exec.c      2017-08-22 14:34:55.868730680 -0700
@@ -36,6 +36,8 @@
 #include "sysemu/cpus.h"
 #include "sysemu/replay.h"

+#include "../patches/afl-qemu-cpu-inl.h"

 typedef struct SyncClocks {
@@ -144,6 +146,8 @@
     int tb_exit;
     uint8_t *tb_ptr = itb->tc_ptr;

+    AFL_QEMU_CPU_SNIPPET2;
+
     qemu_log_mask_and_addr(CPU_LOG_EXEC, itb->pc,
                            "Trace %p [%d: " TARGET_FMT_lx "] %s\n",
                            itb->tc_ptr, cpu->cpu_index, itb->pc,
@@ -365,6 +369,7 @@
             if (!tb) {
                 tb = tb_gen_code(cpu, pc, cs_base, flags, 0);
+                AFL_QEMU_CPU_SNIPPET1;
             }
afl-qemu-cpu-inl.h:定义了与模糊测试相关的处理,下面摘取了其中重要的部分进行说明:
// 通知 tsl(translation handler)对指定基本块进行转换
#define AFL_QEMU_CPU_SNIPPET1 do { \
    afl_request_tsl(pc, cs_base, flags); \
  } while (0)

// 如果执行到入口点,就启动 forkserver,并且记录覆盖率
#define AFL_QEMU_CPU_SNIPPET2 do { \
    if(itb->pc == afl_entry_point) { \
      afl_setup(); \
      afl_forkserver(cpu); \
    } \
    afl_maybe_log(itb->pc); \
  } while (0)

//路径覆盖率记录
static inline void afl_maybe_log(abi_ulong cur_loc) {

    static __thread abi_ulong prev_loc;
    // 避免记录不在 start ~ end 范围的覆盖率
    if (cur_loc > afl_end_code || cur_loc < afl_start_code || !afl_area_ptr)
        return;

    cur_loc  = (cur_loc >> 4) ^ (cur_loc << 8);
    cur_loc &= MAP_SIZE - 1;

    // 通过概率插桩进行优化
    if (cur_loc >= afl_inst_rms) return;
    afl_area_ptr[cur_loc ^ prev_loc]++;
    prev_loc = cur_loc >> 1;
}
覆盖计算
AFL++ 的覆盖率是基于 基本块(basic block)和边(edge) 来计算的。
每个基本块有一个唯一 ID,当程序从一个块跳到另一个块时,形成一条边。
AFL++ 的覆盖率是基于边 ID,统计边被访问次数。
边 ID 有碰撞风险,主要因为 map 大小限制和 block/edge ID 分布不均。
原算法快速但存在密集/稀疏分布问题,block ID entropy 不够。
改进方案:
- 使用 hash 生成 block ID。
- 使用 rotate 生成 edge ID。
- 并行 fuzz 使用不同 seed 避免 edge 冲突。
这些改进在保持性能的同时提高 map 分布均匀性和并行 fuzz 的效率。
执行时:
使用一维字节数组(按边 ID 索引)统计每条边被访问的次数。
还维护一个 累积覆盖率数组,将每条边访问次数映射到一个桶(bucket):
1, 2, 3, 4-7, 8-15, 16-31, 32-127, 128+理论上,边被访问次数的小幅变化(比如 23 次 vs 24 次)并不重要,但第一次访问或者进入新的桶是有意义的。
每次执行后,如果出现新的路径(覆盖率不同于累积数组),则将该输入保留为新种子,并更新累积数组。
示例:
function() {
  A:
    some code
  B:
    if (x) goto C; else goto D;
  C:
    some code
    goto E
  D:
    some code
    goto B
  E:
    return
}
两个跳转位置之间的代码块即为一个基本块。
Edge 表示两个直接连接的基本块之间的唯一关系,如上例:
      Block A
        |
        v
      Block B  <------+
    /        \       |
    v          v      |
Block C    Block D --+
    \
      v
      Block E
每条基本块间的连接线就是一个 edge。一些循环自回环的基本块也算作 edge。
核心模块分析
afl-fuzz.c 是 AFL 的调度中心。插桩模块负责在目标程序里写入“记录 coverage + 建立 forkserver”的逻辑,而 afl-fuzz 负责另外四件事:
- 维护语料队列,决定“下一个该 fuzz 谁”
- 把输入写给目标程序并收集执行结果
- 根据 coverage / crash / timeout 判断结果是否值得保留
- 持续调整下一轮变异策略
照着大佬的图画的:
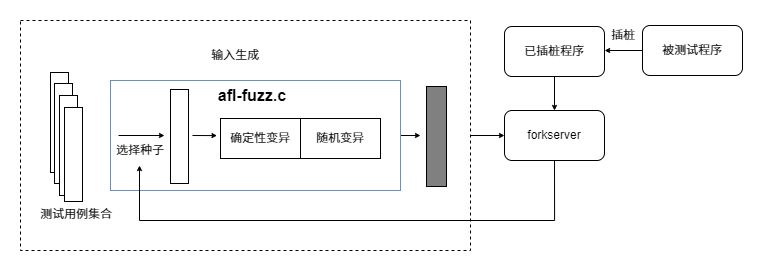
如果只看主线,main() 的工作流可以概括成下面几步:
- 解析参数和环境变量,确定运行模式。
- 初始化共享内存、输出目录、种子队列、字典、统计信息。
- 对初始种子做 dry run 和 calibration,确认目标程序能稳定运行。
- 进入
while (1)主循环,不断执行fuzz_one()。 - 发现新路径就入队,发现 crash / hang 就落盘,周期性同步和展示状态。
参数处理
main() 一开始用 getopt() 解析 -i、-o、-f、-m、-t、-M/-S、-Q、-n、-x 等参数。这里真正重要的不是“把参数读出来”,而是它会立刻把整个 fuzzing 会话的边界条件定死:
- 输入目录、输出目录和目标程序路径是否合法
- 是否启用
qemu_mode、dumb_mode、crash_mode - 是否允许
forkserver - 是否开启并行同步
- 是否启用字典、超时、自定义内存限制等策略
紧接着会读取一批环境变量,例如:
AFL_NO_FORKSRV:禁用 forkserverAFL_FAST_CAL:缩短 calibration 次数AFL_NO_ARITH:跳过算术类确定性变异AFL_SHUFFLE_QUEUE:打乱初始队列AFL_HANG_TMOUT:覆盖 hang 的判定阈值AFL_PRELOAD:给目标程序注入额外 so
这一阶段还会做一些“运行前就必须失败”的检查,例如:
- 输入目录和输出目录不能相同
-C和-n不能同时开-Q和-n不能同时开- CPU 绑定、core dump、ASAN/MSAN 相关配置是否合理
这些检查看起来琐碎,但本质上是在保证后面的反馈信号可解释。否则你看到的 crash、timeout、无 coverage,都可能只是启动参数有问题。
对应的实现代码如下:
while ((opt = getopt(argc, argv, "+i:o:f:m:b:t:T:dnCB:S:M:x:QV")) > 0)
  switch (opt) {
    case 'i':
      if (in_dir) FATAL("Multiple -i options not supported");
      in_dir = optarg;
      if (!strcmp(in_dir, "-")) in_place_resume = 1;
      break;

    case 'M': {
        if (sync_id) FATAL("Multiple -S or -M options not supported");
        sync_id = ck_strdup(optarg);
        force_deterministic = 1;
      }
      break;

    case 't': {
        u8 suffix = 0;
        if (sscanf(optarg, "%u%c", &exec_tmout, &suffix) < 1 ||
            optarg[0] == '-') FATAL("Bad syntax used for -t");
        if (suffix == '+') timeout_given = 2; else timeout_given = 1;
        break;
    }

    case 'C':
      crash_mode = FAULT_CRASH;
      break;

    case 'n':
      if (getenv("AFL_DUMB_FORKSRV")) dumb_mode = 2; else dumb_mode = 1;
      break;

    case 'Q':
      qemu_mode = 1;
      if (!mem_limit_given) mem_limit = MEM_LIMIT_QEMU;
      break;
  }

if (optind == argc || !in_dir || !out_dir) usage(argv[0]);

setup_signal_handlers();
check_asan_opts();

if (sync_id) fix_up_sync();

if (!strcmp(in_dir, out_dir))
  FATAL("Input and output directories can't be the same");

if (getenv("AFL_NO_FORKSRV"))    no_forkserver    = 1;
if (getenv("AFL_NO_ARITH"))      no_arith         = 1;
if (getenv("AFL_SHUFFLE_QUEUE")) shuffle_queue    = 1;
if (getenv("AFL_FAST_CAL"))      fast_cal         = 1;
初始化
初始化中最关键的是 setup_shm()。它做了三件事情:
- 创建共享内存
trace_bits - 初始化三张“尚未见过”的位图:
virgin_bits、virgin_tmout、virgin_crash - 通过环境变量把共享内存 ID 传给目标程序
这里的角色分工很清楚:
trace_bits:本次执行写出来的覆盖率结果virgin_bits:普通执行路径里哪些 edge 还从未见过virgin_tmout:哪些 timeout 轨迹还是新的virgin_crash:哪些 crash 轨迹还是新的
后续 AFL 的所有判断,几乎都建立在“本次 trace_bits 与这些 virgin 位图相比有没有新增”这个问题上。
除此之外,初始化阶段还会完成:
read_testcases():把输入目录中的种子读入队列setup_stdio_file():准备<out_dir>/.cur_inputload_extras():加载用户字典check_binary():确认目标程序是否插桩find_timeout():如果用户没给-t,根据 dry run 自动估计超时
setup_shm() 的实现如下:
EXP_ST void setup_shm(void) {
  u8* shm_str;

  if (!in_bitmap) memset(virgin_bits, 255, MAP_SIZE);
  memset(virgin_tmout, 255, MAP_SIZE);
  memset(virgin_crash, 255, MAP_SIZE);

  shm_id = shmget(IPC_PRIVATE, MAP_SIZE, IPC_CREAT | IPC_EXCL | 0600);
  if (shm_id < 0) PFATAL("shmget() failed");

  atexit(remove_shm);

  shm_str = alloc_printf("%d", shm_id);
  if (!dumb_mode) setenv(SHM_ENV_VAR, shm_str, 1);
  ck_free(shm_str);

  trace_bits = shmat(shm_id, NULL, 0);
  if (trace_bits == (void *)-1) PFATAL("shmat() failed");
}
Dry Run 与校准
perform_dry_run() 会遍历初始语料,对每个种子调用 calibrate_case()。这个阶段不是正式 fuzz,而是在回答三个问题:
- 目标程序能不能被正常拉起?
- 同一个输入多次执行,coverage 稳不稳定?
- 这个种子有没有带来任何有效覆盖?
calibrate_case() 是核心函数之一。它内部会:
- 如果 forkserver 还没启动,就先调用
init_forkserver() - 重复执行当前输入若干轮
- 对每轮
trace_bits做hash32(),判断路径是否稳定 - 用
has_new_bits(virgin_bits)检查是否带来新 edge - 统计
exec_us、bitmap_size、exec_cksum - 调用
update_bitmap_score()更新“哪些样本最值得保留”
其中有两个细节非常重要。
第一,has_new_bits() 的返回值不是简单的布尔值:
0:没有任何新信息1:没有新 edge,但已有 edge 的 hit count 类别发生变化2:发现了真正新的 edge
第二,AFL 会显式标记“不稳定输入”。如果同一个 seed 多次执行拿到不同的 trace_bits,对应字节会被记进 var_bytes,样本会被标成 var_behavior。这并不一定说明程序有 bug,但说明这个输入的反馈信号噪声较大。
calibrate_case() 和 has_new_bits() 的关键实现如下:
static u8 calibrate_case(char** argv, struct queue_entry* q, u8* use_mem,
                         u32 handicap, u8 from_queue) {
  u8  fault = 0, new_bits = 0, var_detected = 0, hnb = 0,
      first_run = (q->exec_cksum == 0);

  if (!from_queue || resuming_fuzz)
    use_tmout = MAX(exec_tmout + CAL_TMOUT_ADD,
                    exec_tmout * CAL_TMOUT_PERC / 100);

  stage_name = "calibration";
  stage_max  = fast_cal ? 3 : CAL_CYCLES;

  if (dumb_mode != 1 && !no_forkserver && !forksrv_pid)
    init_forkserver(argv);

  for (stage_cur = 0; stage_cur < stage_max; stage_cur++) {
    write_to_testcase(use_mem, q->len);
    fault = run_target(argv, use_tmout);

    if (stop_soon || fault != crash_mode) goto abort_calibration;

    if (!dumb_mode && !stage_cur && !count_bytes(trace_bits)) {
      fault = FAULT_NOINST;
      goto abort_calibration;
    }

    cksum = hash32(trace_bits, MAP_SIZE, HASH_CONST);

    if (q->exec_cksum != cksum) {
      hnb = has_new_bits(virgin_bits);
      if (hnb > new_bits) new_bits = hnb;

      if (q->exec_cksum) {
        for (i = 0; i < MAP_SIZE; i++) {
          if (!var_bytes[i] && first_trace[i] != trace_bits[i]) {
            var_bytes[i] = 1;
            stage_max    = CAL_CYCLES_LONG;
          }
        }
        var_detected = 1;
      } else {
        q->exec_cksum = cksum;
        memcpy(first_trace, trace_bits, MAP_SIZE);
      }
    }
  }
}

static inline u8 has_new_bits(u8* virgin_map) {
  u8 ret = 0;

  while (i--) {
    if (unlikely(*current) && unlikely(*current & *virgin)) {
      if (likely(ret < 2)) {
        if ((cur[0] && vir[0] == 0xff) || (cur[1] && vir[1] == 0xff))
          ret = 2;
        else
          ret = 1;
      }
      *virgin &= ~*current;
    }
    current++;
    virgin++;
  }

  if (ret && virgin_map == virgin_bits) bitmap_changed = 1;
  return ret;
}
语料评分与精简
校准完成后,AFL 并不会把所有样本一视同仁。update_bitmap_score() 和 cull_queue() 共同实现了“收藏夹”机制。
update_bitmap_score() 的逻辑是:
- 对于
trace_bits中命中的每一个字节,维护一个top_rated[i] - 如果多个样本都能覆盖这个位置,优先保留
exec_us * len更小的那个
也就是说,AFL 偏爱这类样本:
- 跑得快
- 文件短
- 覆盖又能代表某些独特路径
然后 cull_queue() 会从 top_rated[] 中反推出一批 favored 样本,并把其他样本打上冗余标记。后续 fuzz_one() 会优先处理这些 favored 且尚未充分 fuzz 的条目。
这一步非常关键,因为 AFL 不是“均匀”分配算力,而是始终在做语料压缩和调度偏置。
这部分对应的实现代码如下:
static void update_bitmap_score(struct queue_entry* q) {
  u32 i;
  u64 fav_factor = q->exec_us * q->len;

  for (i = 0; i < MAP_SIZE; i++)
    if (trace_bits[i]) {
      if (top_rated[i]) {
        if (fav_factor > top_rated[i]->exec_us * top_rated[i]->len) continue;

        if (!--top_rated[i]->tc_ref) {
          ck_free(top_rated[i]->trace_mini);
          top_rated[i]->trace_mini = 0;
        }
      }

      top_rated[i] = q;
      q->tc_ref++;

      if (!q->trace_mini) {
        q->trace_mini = ck_alloc(MAP_SIZE >> 3);
        minimize_bits(q->trace_mini, trace_bits);
      }

      score_changed = 1;
    }
}

static void cull_queue(void) {
  if (dumb_mode || !score_changed) return;

  score_changed = 0;
  memset(temp_v, 255, MAP_SIZE >> 3);

  queued_favored  = 0;
  pending_favored = 0;

  while (q) {
    q->favored = 0;
    q = q->next;
  }

  for (i = 0; i < MAP_SIZE; i++)
    if (top_rated[i] && (temp_v[i >> 3] & (1 << (i & 7)))) {
      while (j--)
        if (top_rated[i]->trace_mini[j])
          temp_v[j] &= ~top_rated[i]->trace_mini[j];

      top_rated[i]->favored = 1;
      queued_favored++;

      if (!top_rated[i]->was_fuzzed) pending_favored++;
    }
}
forkserver 与执行模型
如果每次测试都 execve() 一次目标程序,性能会非常差。AFL 的做法是:
- 只在第一次真正执行目标时启动目标程序
- 让插桩代码中的 forkserver 停在程序早期
- 之后每次测试都只让 forkserver
fork()一个子进程去跑输入
init_forkserver() 在 fuzzer 侧的职责是:
- 创建两条管道:控制管道和状态管道
fork()出目标程序- 在子进程里重定向 stdin/stdout/stderr,并
execv()目标程序 - 等待插桩代码从状态管道发来 4 字节握手
一旦握手成功,说明目标程序内的 forkserver 已经就位。后续正式执行由 run_target() 完成:
- 先把
trace_bits清零。 - 向控制管道写 4 字节,通知 forkserver 开始一次执行。
- 从状态管道读回本次 child 的 pid。
- 设置
ITIMER_REAL,超时则由信号处理逻辑杀掉 child。 - 等待状态管道返回 child 退出状态。
- 对
trace_bits做classify_counts(),把精确 hit count 压缩到几个桶里。 - 按退出状态把结果分类成
FAULT_NONE、FAULT_TMOUT、FAULT_CRASH、FAULT_ERROR。
这里的 classify_counts() 也很重要。AFL 并不关心“某条 edge 到底走了 137 次还是 138 次”,它只关心计数是否跨过若干等级。这样既能保留“路径热度”的粗粒度信息,又能减少噪声。
init_forkserver() 和 run_target() 的核心实现如下:
EXP_ST void init_forkserver(char** argv) {
  int st_pipe[2], ctl_pipe[2];

  if (pipe(st_pipe) || pipe(ctl_pipe)) PFATAL("pipe() failed");

  forksrv_pid = fork();
  if (forksrv_pid < 0) PFATAL("fork() failed");

  if (!forksrv_pid) {
    setsid();

    dup2(dev_null_fd, 1);
    dup2(dev_null_fd, 2);

    if (out_file) dup2(dev_null_fd, 0);
    else {
      dup2(out_fd, 0);
      close(out_fd);
    }

    if (dup2(ctl_pipe[0], FORKSRV_FD) < 0) PFATAL("dup2() failed");
    if (dup2(st_pipe[1], FORKSRV_FD + 1) < 0) PFATAL("dup2() failed");

    execv(target_path, argv);
    *(u32*)trace_bits = EXEC_FAIL_SIG;
    exit(0);
  }

  fsrv_ctl_fd = ctl_pipe[1];
  fsrv_st_fd  = st_pipe[0];
  rlen = read(fsrv_st_fd, &status, 4);
}

static u8 run_target(char** argv, u32 timeout) {
  memset(trace_bits, 0, MAP_SIZE);
  MEM_BARRIER();

  if ((res = write(fsrv_ctl_fd, &prev_timed_out, 4)) != 4)
    RPFATAL(res, "Unable to request new process from fork server (OOM?)");

  if ((res = read(fsrv_st_fd, &child_pid, 4)) != 4)
    RPFATAL(res, "Unable to request new process from fork server (OOM?)");

  setitimer(ITIMER_REAL, &it, NULL);

  if ((res = read(fsrv_st_fd, &status, 4)) != 4)
    RPFATAL(res, "Unable to communicate with fork server (OOM?)");

  total_execs++;
  classify_counts((u64*)trace_bits);

  if (WIFSIGNALED(status) && !stop_soon) {
    kill_signal = WTERMSIG(status);
    if (child_timed_out && kill_signal == SIGKILL) return FAULT_TMOUT;
    return FAULT_CRASH;
  }

  if (uses_asan && WEXITSTATUS(status) == MSAN_ERROR) return FAULT_CRASH;
  return FAULT_NONE;
}
主循环
初始化结束后,main() 进入无限循环。主循环非常短,但串起了整个 fuzzer:
cull_queue():根据最新评分重新计算 favored 集合- 如果当前 queue 周期结束,递增
queue_cycle,决定是否开启 splicing - 必要时调用
sync_fuzzers()和其他实例同步 - 调用
fuzz_one()真正处理当前样本 - 前进到下一个队列条目
如果一个完整周期都没有发现新路径,use_splicing 会被打开。也就是说,AFL 会先优先把“单个样本自己能榨出的信息”榨干,实在卡住了再尝试样本拼接。
主循环对应的实现代码如下:
while (1) {
  u8 skipped_fuzz;

  cull_queue();

  if (!queue_cur) {
    queue_cycle++;
    current_entry     = 0;
    cur_skipped_paths = 0;
    queue_cur         = queue;

    show_stats();

    if (queued_paths == prev_queued) {
      if (use_splicing) cycles_wo_finds++;
      else use_splicing = 1;
    } else cycles_wo_finds = 0;

    prev_queued = queued_paths;

    if (sync_id && queue_cycle == 1 && getenv("AFL_IMPORT_FIRST"))
      sync_fuzzers(use_argv);
  }

  skipped_fuzz = fuzz_one(use_argv);

  if (!stop_soon && sync_id && !skipped_fuzz)
    if (!(sync_interval_cnt++ % SYNC_INTERVAL))
      sync_fuzzers(use_argv);

  if (stop_soon) break;

  queue_cur = queue_cur->next;
  current_entry++;
}
fuzz_one()
fuzz_one() 是整个 afl-fuzz.c 最重要的函数。它一轮只处理一个 queue_entry,但内部把“样本选择、修剪、评分、变异、执行、保存结果”全部串在了一起。
它的大致流程如下:
- 根据
favored/was_fuzzed/pending_favored决定这次要不要跳过该样本。 - 用
mmap()把当前样本映射到内存。 - 如果这个样本之前校准失败过,重新做一次
calibrate_case()。 - 如果还没 trim 过,则执行
trim_case()。 - 计算
perf_score,决定后面 havoc 阶段要给它多少算力。 - 先做确定性变异;做完后再进入随机 havoc。
- 如果长时间没有新发现,再尝试 splicing。
1. Trimming
trim_case() 的目标很直接:在不改变 coverage 的前提下,把输入尽量缩短。
它的做法不是按字节硬删,而是从较大的块开始删除:
- 先把文件长度向上取整到 2 的幂
- 初始删除块大小约为文件的
1/16 - 每尝试完一轮后把删除粒度减半
- 每次删完都重新执行目标,看
hash32(trace_bits)是否仍等于原来的exec_cksum
如果 checksum 不变,就说明被删掉的那一段对当前路径没有贡献,可以永久移除。
这一步的意义很大:
- 后续确定性变异的成本与输入长度近似成正比
- 更短的样本更容易成为
top_rated - 也更容易暴露真正控制路径的关键字节
trim_case() 的实现代码如下:
static u8 trim_case(char** argv, struct queue_entry* q, u8* in_buf) {
  u8  needs_write = 0, fault = 0;
  u32 remove_len;
  u32 len_p2;

  if (q->len < 5) return 0;

  len_p2 = next_p2(q->len);
  remove_len = MAX(len_p2 / TRIM_START_STEPS, TRIM_MIN_BYTES);

  while (remove_len >= MAX(len_p2 / TRIM_END_STEPS, TRIM_MIN_BYTES)) {
    u32 remove_pos = remove_len;

    while (remove_pos < q->len) {
      u32 trim_avail = MIN(remove_len, q->len - remove_pos);

      write_with_gap(in_buf, q->len, remove_pos, trim_avail);
      fault = run_target(argv, exec_tmout);
      cksum = hash32(trace_bits, MAP_SIZE, HASH_CONST);

      if (cksum == q->exec_cksum) {
        u32 move_tail = q->len - remove_pos - trim_avail;
        q->len -= trim_avail;
        len_p2  = next_p2(q->len);
        memmove(in_buf + remove_pos, in_buf + remove_pos + trim_avail,
                move_tail);
        if (!needs_write) {
          needs_write = 1;
          memcpy(clean_trace, trace_bits, MAP_SIZE);
        }
      } else remove_pos += remove_len;
    }

    remove_len >>= 1;
  }
}
2. 确定性变异
确定性变异阶段的特点是“系统性”。AFL 会按固定顺序穷举一组经典变异:
- bitflip:翻转 1/2/4 bit,或 1/2/4 byte
- arith:对 8/16/32 位整数做
+j/-j,其中j在1..ARITH_MAX - interest:把字节、字、双字替换成预定义的边界值
- extras:用用户字典或自动提取出的 token 做覆盖 / 插入
这个阶段不是为了“随机撞运气”,而是为了系统识别输入结构,例如:
- 哪些字节一改就会走新路径
- 哪些字节基本无关紧要
- 哪些位置像长度字段、magic、枚举值、边界值
源码里有三组辅助函数专门用来去重:
could_be_bitflip()could_be_arith()could_be_interest()
它们的作用是避免重复做“本质上已经被前面阶段覆盖过”的尝试。例如一个值如果已经能由 bitflip 导出,就没必要再让 arith 阶段重复跑一次。
另外,bitflip 阶段还会顺手做一件很聪明的事情:自动提取 token。fuzz_one() 会观察哪些连续字节在翻转后会导致路径一起变化,并把这类片段候选记进 a_extras,后面在 dictionary 阶段复用。
fuzz_one() 里确定性阶段的实现片段如下:
orig_perf = perf_score = calculate_score(queue_cur);

if (skip_deterministic || queue_cur->was_fuzzed || queue_cur->passed_det)
  goto havoc_stage;

stage_short = "flip1";
stage_max   = len << 3;
stage_name  = "bitflip 1/1";

orig_hit_cnt = queued_paths + unique_crashes;
prev_cksum = queue_cur->exec_cksum;

for (stage_cur = 0; stage_cur < stage_max; stage_cur++) {
  stage_cur_byte = stage_cur >> 3;

  FLIP_BIT(out_buf, stage_cur);
  if (common_fuzz_stuff(argv, out_buf, len)) goto abandon_entry;
  FLIP_BIT(out_buf, stage_cur);

  if (!dumb_mode && (stage_cur & 7) == 7) {
    u32 cksum = hash32(trace_bits, MAP_SIZE, HASH_CONST);

    if (cksum != queue_cur->exec_cksum) {
      if (a_len < MAX_AUTO_EXTRA) a_collect[a_len] = out_buf[stage_cur >> 3];
      a_len++;
    }
  }
}

stage_name  = "bitflip 2/1";
stage_short = "flip2";
stage_max   = (len << 3) - 1;

for (stage_cur = 0; stage_cur < stage_max; stage_cur++) {
  FLIP_BIT(out_buf, stage_cur);
  FLIP_BIT(out_buf, stage_cur + 1);

  if (common_fuzz_stuff(argv, out_buf, len)) goto abandon_entry;

  FLIP_BIT(out_buf, stage_cur);
  FLIP_BIT(out_buf, stage_cur + 1);
}
3. 随机变异与拼接
确定性阶段跑完之后,就会进入 havoc。这也是 AFL 最“暴力”的阶段。
havoc 的特点有两个:
- 单轮不是只做一次变异,而是会随机叠加多次操作
- 操作集合既包括 bitflip / 算术 / interest,也包括插入、删除、复制、覆盖、字典替换等结构性修改
典型操作包括:
- 随机改一个 bit / byte / word / dword
- 随机加减小整数
- 删除一段字节
- 复制一段已有字节到别处
- 插入常量块或字典 token
- 用另一段内容覆盖当前位置
calculate_score() 会决定一个样本在 havoc 中值得跑多少轮,评分因素主要有:
- 执行速度快不快
- 覆盖位图大小大不大
- 样本是不是比较“晚”才发现的
- 样本所在路径深度深不深
如果 havoc 过程中持续发现新路径,AFL 还会动态把 stage_max 拉长,继续多给它一些预算。
如果整个周期都没有新发现,才会启用 splicing。它会:
- 随机挑另一个样本
- 找出两个样本第一个和最后一个差异位置
- 在差异区间中间找个点把它们拼起来
- 然后再跳回
havoc_stage
所以 splicing 不是独立阶段,而是“构造一个新底稿,再继续随机轰炸”。
calculate_score()、havoc 和 splicing 的实现片段如下:
static u32 calculate_score(struct queue_entry* q) {
  u32 avg_exec_us = total_cal_us / total_cal_cycles;
  u32 avg_bitmap_size = total_bitmap_size / total_bitmap_entries;
  u32 perf_score = 100;

  if (q->exec_us * 0.1 > avg_exec_us) perf_score = 10;
  else if (q->exec_us * 0.25 > avg_exec_us) perf_score = 25;
  else if (q->exec_us * 0.5 > avg_exec_us) perf_score = 50;
  else if (q->exec_us * 4 < avg_exec_us) perf_score = 300;

  if (q->bitmap_size * 0.3 > avg_bitmap_size) perf_score *= 3;
  else if (q->bitmap_size * 3 < avg_bitmap_size) perf_score *= 0.25;

  switch (q->depth) {
    case 4 ... 7:   perf_score *= 2; break;
    case 8 ... 13:  perf_score *= 3; break;
    case 14 ... 25: perf_score *= 4; break;
    default:        perf_score *= 5;
  }

  if (perf_score > HAVOC_MAX_MULT * 100) perf_score = HAVOC_MAX_MULT * 100;
  return perf_score;
}

for (stage_cur = 0; stage_cur < stage_max; stage_cur++) {
  u32 use_stacking = 1 << (1 + UR(HAVOC_STACK_POW2));

  for (i = 0; i < use_stacking; i++) {
    switch (UR(15 + ((extras_cnt + a_extras_cnt) ? 2 : 0))) {
      case 10:
        out_buf[UR(temp_len)] ^= 1 + UR(255);
        break;

      case 11 ... 12:
        del_len = choose_block_len(temp_len - 1);
        del_from = UR(temp_len - del_len + 1);
        memmove(out_buf + del_from, out_buf + del_from + del_len,
                temp_len - del_from - del_len);
        temp_len -= del_len;
        break;

      case 13:
        clone_len  = choose_block_len(temp_len);
        clone_from = UR(temp_len - clone_len + 1);
        break;
    }
  }
}

if (use_splicing && splice_cycle++ < SPLICE_CYCLES &&
    queued_paths > 1 && queue_cur->len > 1) {
  do { tid = UR(queued_paths); } while (tid == current_entry);
  locate_diffs(in_buf, new_buf, MIN(len, target->len), &f_diff, &l_diff);
  split_at = f_diff + UR(l_diff - f_diff);
  memcpy(new_buf, in_buf, split_at);
  in_buf = new_buf;
  goto havoc_stage;
}
执行反馈
不管上层做的是 bitflip、arith、interest、extras、havoc 还是 splice,最终都会落到 common_fuzz_stuff():
- 把变异后的输入写到
.cur_input - 调用
run_target() - 调用
save_if_interesting() - 更新统计信息
这说明 AFL 的核心闭环其实非常统一:
变异输入 -> 执行目标 -> 比较 coverage -> 决定是否保存
上层所有复杂的 mutation,本质上都是在给这个闭环喂不同的候选输入。
common_fuzz_stuff() 的实现如下:
EXP_ST u8 common_fuzz_stuff(char** argv, u8* out_buf, u32 len) {
  u8 fault;

  if (post_handler) {
    out_buf = post_handler(out_buf, &len);
    if (!out_buf || !len) return 0;
  }

  write_to_testcase(out_buf, len);
  fault = run_target(argv, exec_tmout);

  if (stop_soon) return 1;

  if (fault == FAULT_TMOUT) {
    if (subseq_tmouts++ > TMOUT_LIMIT) {
      cur_skipped_paths++;
      return 1;
    }
  } else subseq_tmouts = 0;

  queued_discovered += save_if_interesting(argv, out_buf, len, fault);

  if (!(stage_cur % stats_update_freq) || stage_cur + 1 == stage_max)
    show_stats();

  return 0;
}
Interesting Input
save_if_interesting() 是 AFL 的“判卷器”。它关心的不是“这个输入变了多少”,而是“它带来的反馈值不值得保留”。
对于“符合当前模式预期”的执行结果(fault == crash_mode。默认模式下等价于 FAULT_NONE;如果开启 -C,则等价于 FAULT_CRASH):
- 先调用
has_new_bits(virgin_bits) - 如果返回 0,说明没有新东西,直接丢掉
- 如果返回 1 或 2,就把输入保存到
queue/ - 然后调用
add_to_queue()入队,并对新样本再次做calibrate_case()
这里再次校准很重要,因为 AFL 不希望把“一次性偶然跑出来的新路径”直接当成稳定语料。
对于 hang:
- 增加
total_tmouts - 如果轨迹对
virgin_tmout不是新的,就不保留 - 如果当前
exec_tmout < hang_tmout,会再复现一次确认真的是 hang - 确认后保存到
hangs/
对于 crash:
- 增加
total_crashes - 先把
trace_bits简化,再与virgin_crash比较 - 只有“崩溃轨迹本身是新的”才保存
- 保存路径在
crashes/
这套机制说明 AFL 保存的不是“所有 crash”,而是“去重之后值得看的 crash”。同一个根因如果只是不同输入重复触发,最终通常只会留下少量代表样本。
save_if_interesting() 的实现片段如下:
static u8 save_if_interesting(char** argv, void* mem, u32 len, u8 fault) {
  u8 *fn = "";
  u8 hnb;
  u8 keeping = 0, res;

  if (fault == crash_mode) {
    if (!(hnb = has_new_bits(virgin_bits))) {
      if (crash_mode) total_crashes++;
      return 0;
    }

    fn = alloc_printf("%s/queue/id:%06u,%s", out_dir, queued_paths,
                      describe_op(hnb));
    add_to_queue(fn, len, 0);

    if (hnb == 2) {
      queue_top->has_new_cov = 1;
      queued_with_cov++;
    }

    queue_top->exec_cksum = hash32(trace_bits, MAP_SIZE, HASH_CONST);
    res = calibrate_case(argv, queue_top, mem, queue_cycle - 1, 0);

    fd = open(fn, O_WRONLY | O_CREAT | O_EXCL, 0600);
    ck_write(fd, mem, len, fn);
    close(fd);

    keeping = 1;
  }

  switch (fault) {
    case FAULT_TMOUT:
      total_tmouts++;
      if (!has_new_bits(virgin_tmout)) return keeping;
      break;

    case FAULT_CRASH:
      total_crashes++;
      if (!has_new_bits(virgin_crash)) return keeping;
      break;
  }
}
Crash / Hang 判定
在 run_target() 里,AFL 对执行结果的判定非常直接:
WIFSIGNALED(status)为真,且不是超时触发的SIGKILL,视为 crash- 如果是超时后杀掉 child,记为
FAULT_TMOUT execv()失败会返回FAULT_ERROR- 没有检测到插桩反馈会在 calibration 阶段记为
FAULT_NOINST
因此,普通“解析失败”通常不算 crash。比如一个 PDF 解析器遇到坏格式:
- 如果只是返回错误码并正常退出,不算 crash
- 如果打印错误日志但进程正常结束,不算 crash
- 只有真正触发信号异常、ASAN/MSAN 异常退出、或被 hang 逻辑判定卡死,AFL 才会把它记成 fault
并行同步
如果开启 -M / -S,AFL 会定期调用 sync_fuzzers():
- 扫描其他实例的
queue/ - 读取还没有同步过的新样本
- 本地执行一次
run_target() - 再复用同一个
save_if_interesting()判断是否值得入队
这意味着并行模式并不是“盲目拷贝别人队列”,而是“把别人的发现再在本地判一遍”。
sync_fuzzers() 的实现片段如下:
static void sync_fuzzers(char** argv) {
  sd = opendir(sync_dir);

  while ((sd_ent = readdir(sd))) {
    if (sd_ent->d_name[0] == '.' || !strcmp(sync_id, sd_ent->d_name)) continue;

    qd_path = alloc_printf("%s/%s/queue", sync_dir, sd_ent->d_name);
    if (!(qd = opendir(qd_path))) continue;

    qd_synced_path = alloc_printf("%s/.synced/%s", out_dir, sd_ent->d_name);
    id_fd = open(qd_synced_path, O_RDWR | O_CREAT, 0600);
    if (read(id_fd, &min_accept, sizeof(u32)) > 0) lseek(id_fd, 0, SEEK_SET);

    while ((qd_ent = readdir(qd))) {
      if (qd_ent->d_name[0] == '.' ||
          sscanf(qd_ent->d_name, CASE_PREFIX "%06u", &syncing_case) != 1 ||
          syncing_case < min_accept) continue;

      path = alloc_printf("%s/%s", qd_path, qd_ent->d_name);
      fd = open(path, O_RDONLY);
      if (fd < 0) continue;

      if (st.st_size && st.st_size <= MAX_FILE) {
        mem = mmap(0, st.st_size, PROT_READ, MAP_PRIVATE, fd, 0);
        write_to_testcase(mem, st.st_size);
        fault = run_target(argv, exec_tmout);
        queued_imported += save_if_interesting(argv, mem, st.st_size, fault);
      }
    }
  }
}
参考
[原创]漏洞挖掘技术之 AFL 项目分析-二进制漏洞-看雪-安全社区|安全招聘|kanxue.com u1f383/fuzzing-learning-in-30-days A Look at AFL++ Under The Hood | Blog | RITSEC