数据准备
LLM 的性能在很大程度上取决于其训练数据集的质量和规模。然而,即便是很多优秀的开源模型其训练数据集也不会公开,这样即便开源了社区也无法进行迭代开发。
想要微调一个模型加强其在一个专业领域的能力,自然需要先准备大量高质量的相关数据来进行微调训练。
处理数据的一般流程:
- 数据获取:一般从网络上进行爬取。来源主要是网页、公开数据集、书籍论文、代码仓库、百科、论坛帖子等。
- 数据清洗:去重、格式清洗、数据脱敏。去重分精确去重和近似去重;格式清洗去除 HTML 标签、乱码、广告等噪声;同时要做质量过滤,筛掉过短、重复率高、机器生成痕迹明显的内容;数据脱敏则去除或替换手机号、身份证、邮箱、地址等隐私信息。
- 数据标注:实际中常结合人工标注与模型标注,人工用于指令微调、偏好对齐等高质量场景,模型标注用于蒸馏或降低成本;标注类型包括分类标签、实体标注、问答对、对话、偏好排序等。
- 数据增强:通过改写复述、回译、模板生成、对话扩展、负样本构造、多模态增强等方式,增加样本的多样性和数量,提升模型泛化能力。
笔者直接用 codex 蒸馏了一下自己的一些笔记和 CTF-Wiki 文档做了一个微调的数据集:https://huggingface.co/datasets/Nanhang/ctf-dataset
模型微调
SFT(Supervised Fine-Tuning,有监督微调)是在预训练完成后,用带标签的指令-回答数据对模型进行二次训练,让模型学会按人类期望的格式和风格回答问题。如果希望模型胜任某些特定任务,比如理解一段陌生的代码,就需要对它进行微调。
模型的微调方法主要有以下几种:
全量微调
全量微调是指在下游任务数据上,对预训练模型的全部参数进行更新。它能让模型充分适应新任务,效果通常最好,但代价也最大:
- 显存占用高:需要存储全部参数的梯度、优化器状态,对硬件要求极高。
- 训练成本大:参数量越大,训练时间和算力消耗越夸张。
- 易灾难性遗忘:如果下游数据量不足或分布单一,模型可能丢失预训练阶段学到的通用能力。
- 存储开销大:每个任务都要保存一份完整模型权重,多任务场景下难以管理。
因此,全量微调一般只在数据充足、算力充裕、且对效果要求极高的场景下使用。
部分参数微调
部分参数微调的思路是:冻结预训练模型的大部分参数,只训练其中一小部分。常见做法包括:
- 只训练最后几层(如分类头、输出层)。
- 只训练某些特定模块(如注意力层、LayerNorm 层)。
- 冻结底层(负责通用特征),训练顶层(负责任务特定特征)。
这种方式显著降低了显存和计算需求,但效果通常不如全量微调,因为可训练参数太少,模型对下游任务的适应能力有限。
LoRA
LoRA(Low-Rank Adaptation)是在 2021 年由 Microsoft Research 提出的,核心原理是通过低秩矩阵分解进行部分参数微调。
它的基本思路是:不直接修改预训练权重,而是在原权重旁并联一个低秩分支。对于原权重矩阵 ( W ),LoRA 将其更新量分解为两个小矩阵的乘积:
$$ W’ = W + \Delta W = W + BA $$ 其中 ( A ) 和 ( B ) 是远小于原矩阵的低秩矩阵,训练时只更新 ( A ) 和 ( B ),而 ( W ) 保持冻结。
LoRA 的主要优势:
- 参数量极少:可训练参数通常只占原模型的 0.1%~1%,显存占用大幅降低。
- 训练速度快:梯度计算和优化器状态都只针对小矩阵,训练效率高。
- 存储友好:每个任务只需保存很小的 LoRA 权重,方便多任务切换。
- 不破坏原模型:预训练权重保持不变,推理时可选择合并或分离。
- 效果接近全量微调:在多数下游任务上,LoRA 能达到与全量微调相当的水平。
LoRA 也有超参数需要调节,常见的有:
- 秩 r:低秩矩阵的维度,越大表达能力越强,但参数量也越多。
- 缩放系数 alpha:控制 LoRA 分支对原输出的影响程度。
- 目标模块:决定将 LoRA 应用到哪些层,如仅注意力层或全部线性层。
总的来说,LoRA 在效果、成本和灵活性之间取得了很好的平衡,已成为当前大模型微调中最主流的方法之一。
微调qwen3.5-4b
LLaMA-Factory部署
# 克隆仓库
git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git
cd LlamaFactory

# 配置conda环境到数据盘
mkdir -p /root/autodl-tmp/conda/{pkgs,envs}
conda config --add pkgs_dirs /root/autodl-tmp/conda/pkgs
conda config --add envs_dirs /root/autodl-tmp/conda/envs

# 创建虚拟环境(必须Python 3.10)
conda create -n llama-factory python=3.10
conda activate llama-factory

# 安装依赖
pip install -e ".[torch,metrics]"

# 验证安装
llamafactory-cli version

# 启动可视化界面
llamafactory-cli webui
下载基座模型
从 HuggingFace 平台下载模型:
mkdir models

#修改 HuggingFace 的镜像源
export HF_ENDPOINT=https://hf-mirror.com

#修改模型下载的默认位置
export HF_HOME/root/models

# 安装 HuggingFace 官方下载工具
pip3 install -U huggingface_hub --break-system-packages

# 执行下载命令
hf download --resume-download Qwen/Qwen3.5-4B-Base
准备数据集
将数据集文件 ctf_dataset.json 放到 LLama-Factory 的 data 目录下。然后修改 dataset_info.json 文件,添加如下配置:
"ctf_dataset": {
   "file_name": "ctf_dataset.jsonl",
   "formatting": "sharegpt",
   "columns": {
      "messages": "messages"
   },
   "tags": {
      "role_tag": "role",
      "content_tag": "content",
      "user_tag": "user",
      "assistant_tag": "assistant",
      "system_tag": "system"
   }
}
设置微调参数
选择 Qwen3.5-4B-Base 模型,然后选择微调方法为 lora 并配置我们准备好的数据集。这里由于笔者的服务器硬件性能不够,所以这里要开启量化训练,将量化等级设置为 4。这里的 4 通常对应 QLoRA 训练方式,基础模型权重以 4-bit 形式加载,从而显著降低显存占用。
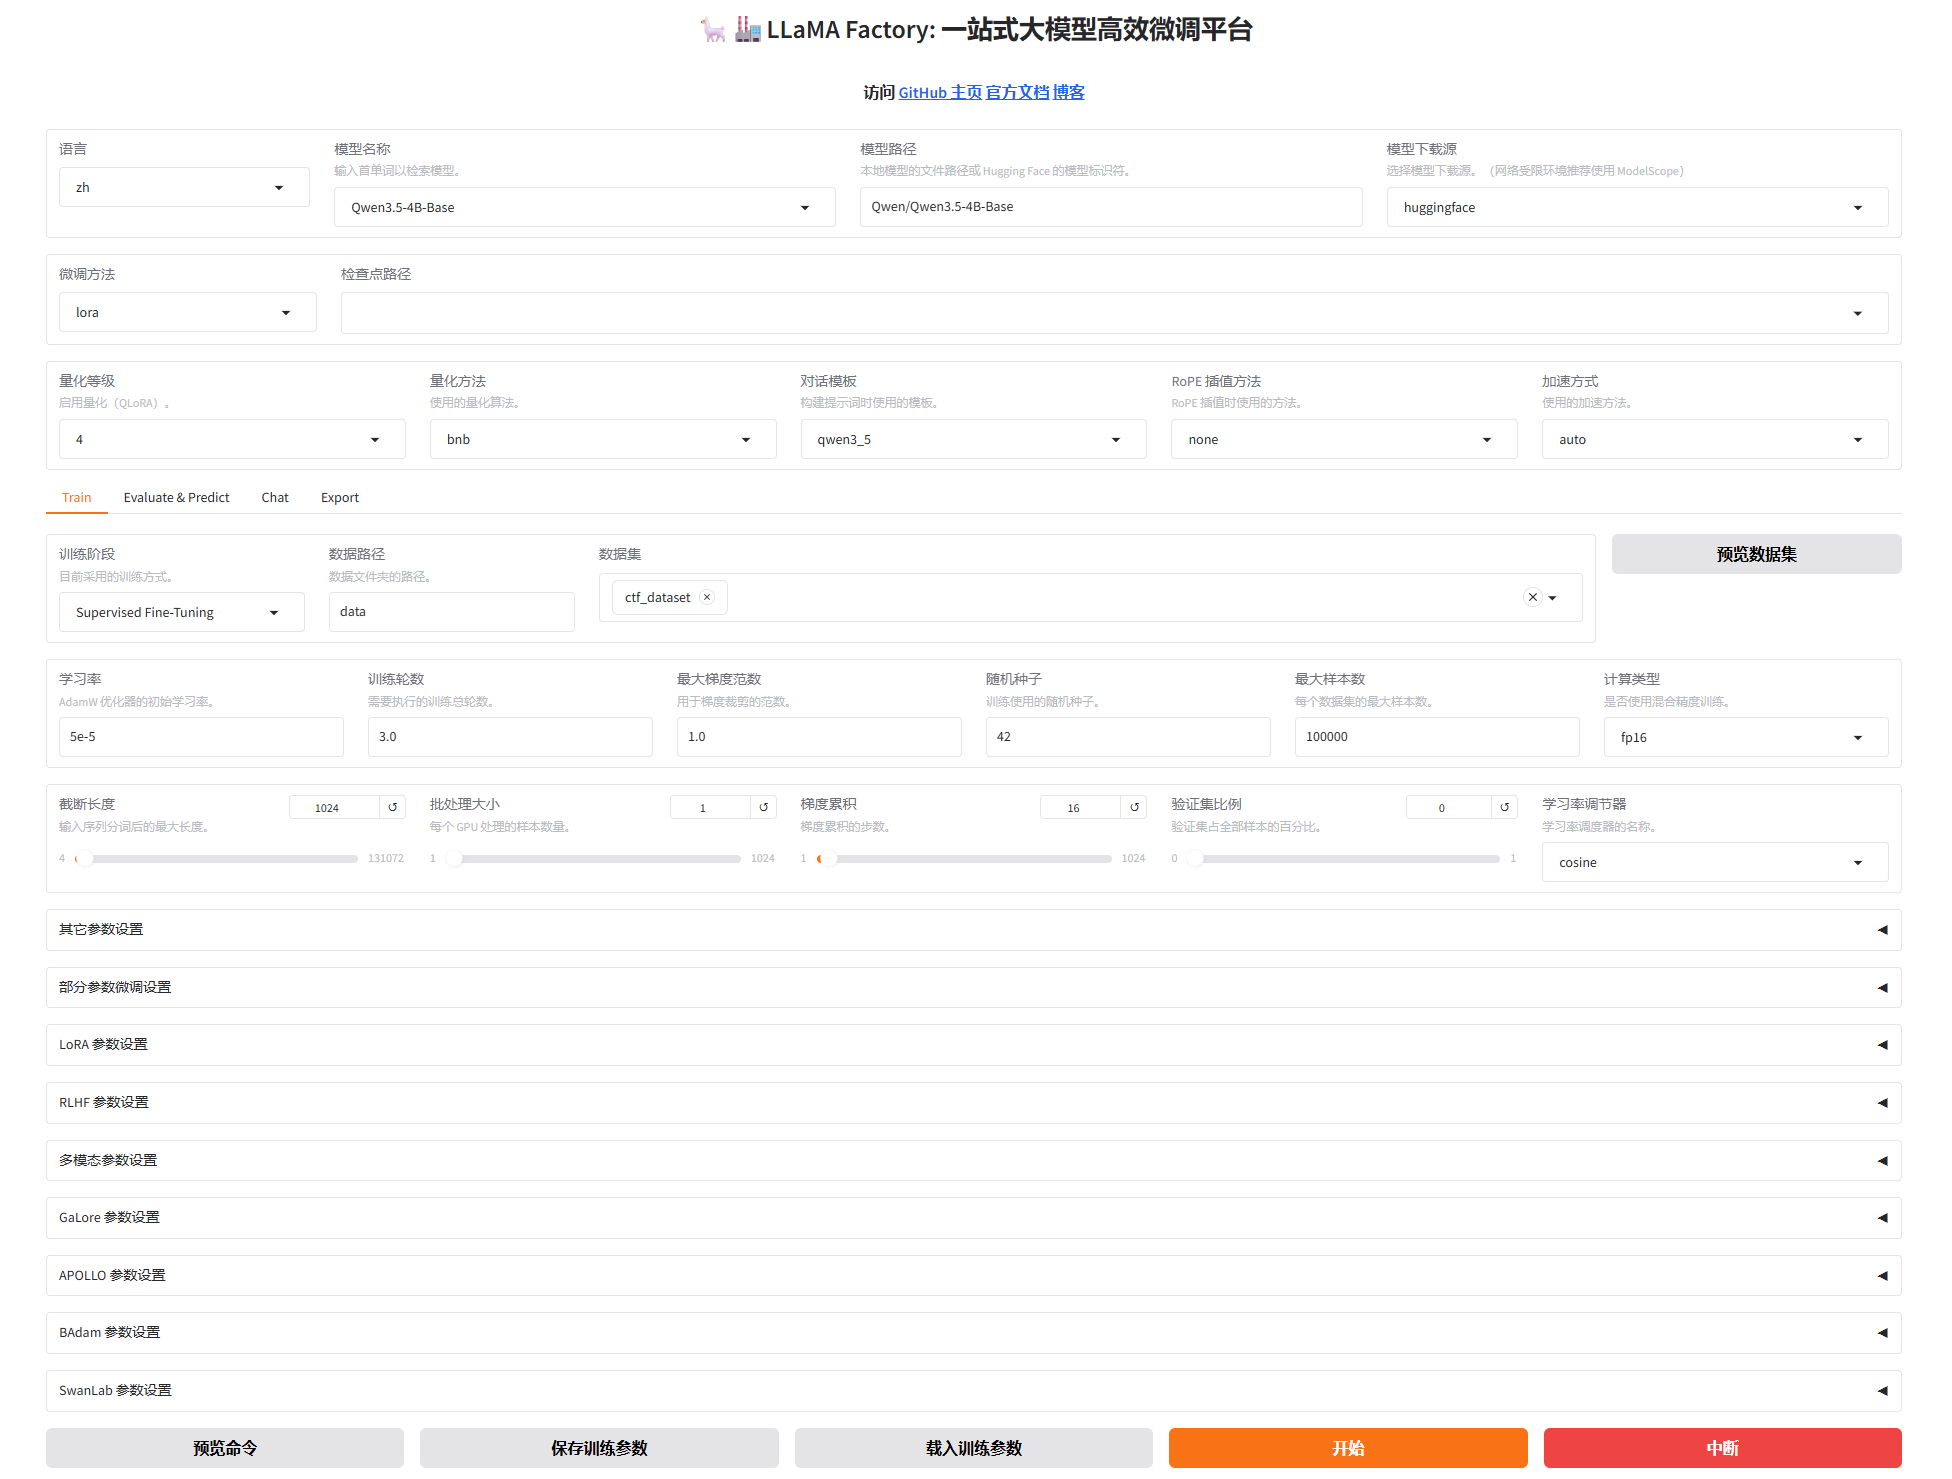
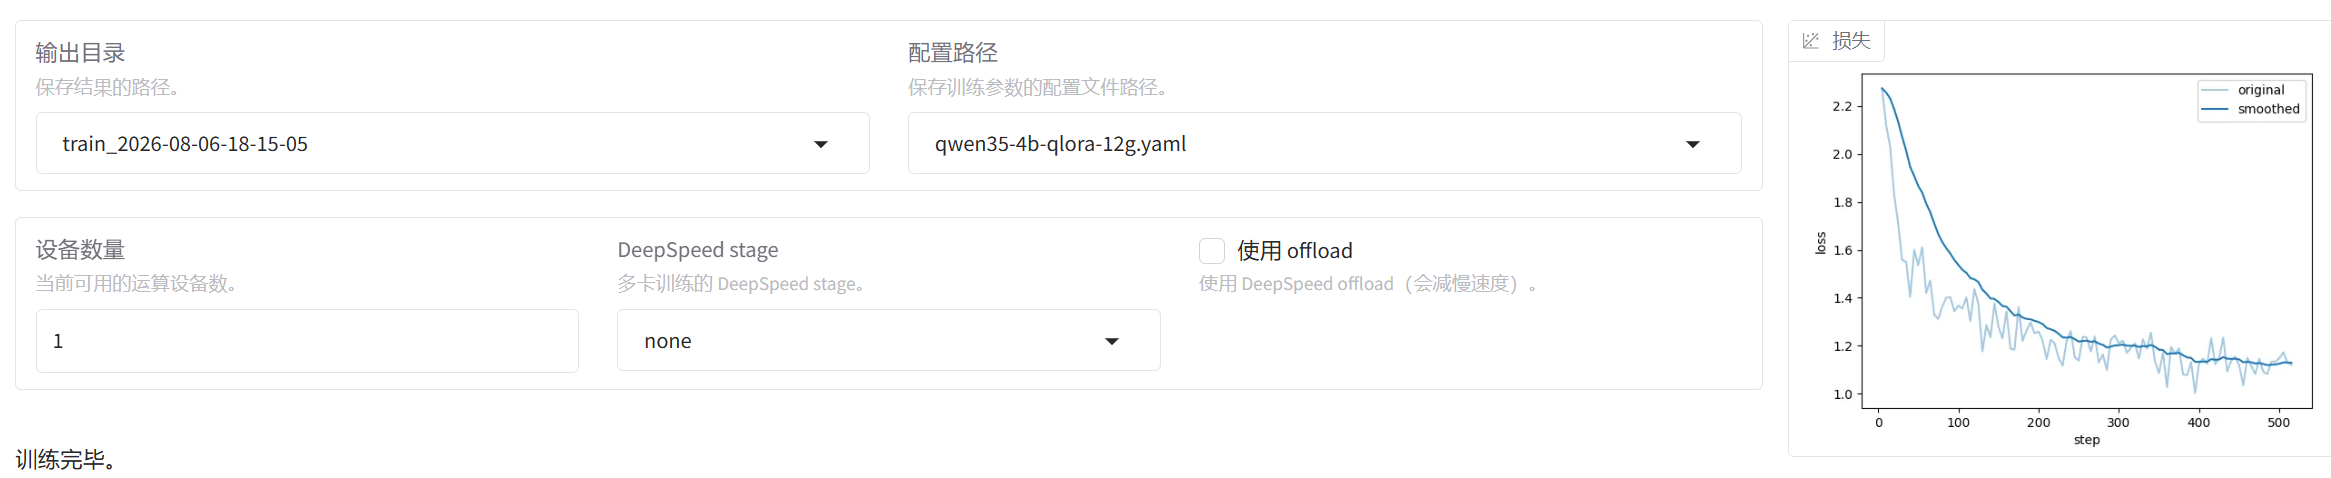
点击开始按钮开始微调,然后需要等待一段时间。模型下载后,可以在界面中观察到训练进度和 loss 曲线。训练完成后,会显示训练完毕。
导出合并后的模型
为什么要合并:因为 Lora 知识通过低秩矩阵调整原始模型的部分权重,而不直接修改原模型的权重。合并步骤将 Lora 权重与原始模型权重融合生成一个完整的模型。
先创建目录:
mkdir -p Models/Qwen3.5-4B-merged
在 LLaMA-Factory 的 WebUI 中,可以直接通过“Export”选项卡完成合并,也可以在命令行下用配置文件执行。这里介绍命令行方式,便于脚本化和复现。
创建一个合并配置文件,例如merge_qwen3_5_4b.yaml:
### model
model_name_or_path: Qwen/Qwen3.5-4B-Base
adapter_name_or_path: saves/qwen3.5-4b/lora/sft
template: qwen
finetuning_type: lora

### export
export_dir: Models/Qwen3.5-4B-merged
export_size: 2
export_device: cpu
export_legacy_format: false
执行合并命令:
bash
llamafactory-cli export merge_qwen3_5_4b.yaml
需要注意:合并时不要使用量化模型或指定量化位数。如果训练时用的是 QLoRA(4-bit 量化模型 + LoRA),合并时需要下载未量化的原始模型作为 base,不能直接从量化权重合并。这是因为量化过程本身是有损的,直接合并会引入额外误差,影响最终模型质量。
合并完成后,Models/Qwen3.5-4B-merged目录下会生成完整的模型权重、配置文件、tokenizer 等,可以直接用于推理部署,无需再单独加载 LoRA 适配器。
参考
使用 LlamaFactory 微调最新一代 Qwen3.5 模型辨别人形机器人型号 | LlamaFactory Blog LoRA 算法论文解读 & 开发人员如何微调大模型并暴露可调用接口